textGrain : le grain de sable dans la machine
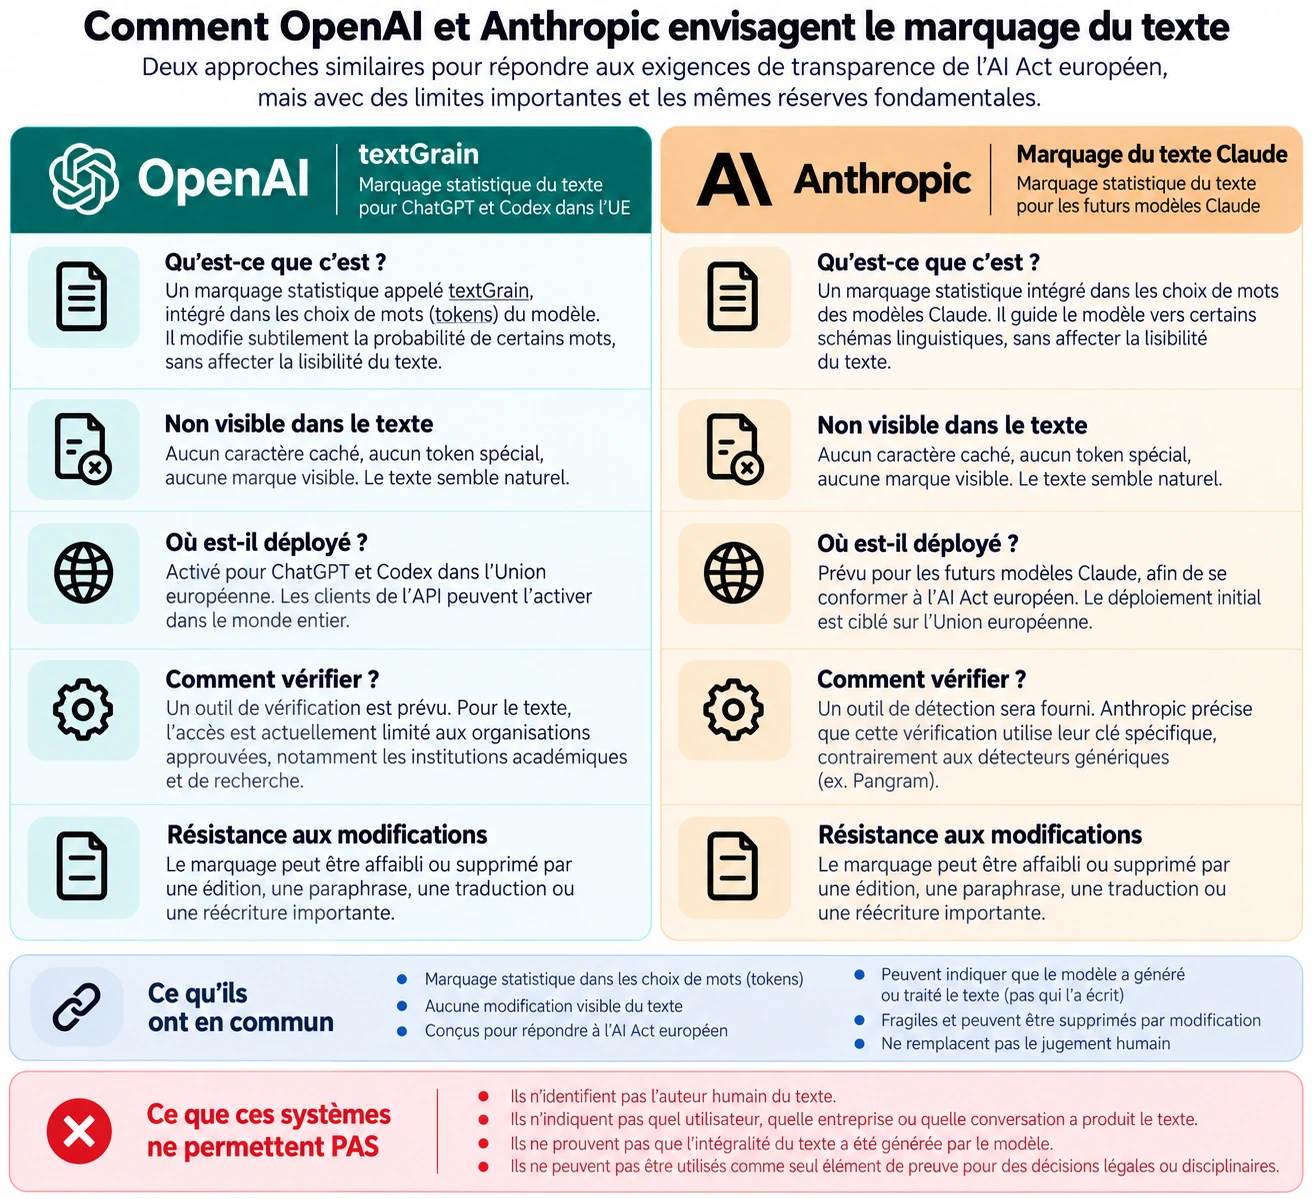
Comment savoir si un texte a été écrit par une IA ? La réponse semblait évidente : il suffirait de le marquer. OpenAI vient d'annoncer le déploiement progressif de textGrain*, un système de watermarking destiné aux textes générés par ChatGPT et Codex dans l'Union européenne.1 Anthropic a de son côté présenté son propre mécanisme de watermarking pour Claude.2
Le principe est séduisant. Lorsqu'un modèle génère du texte, il choisit en permanence entre plusieurs mots ou fragments de mots possibles, souvent naturels et plus ou moins équivalents. Le watermark oriente très légèrement certains de ces choix afin de laisser, sur un volume de texte suffisant, une empreinte statistique.
Cette empreinte est invisible : pas d'espaces spéciaux, pas de caractères Unicode cachés, pas de mystérieuse chaîne à découvrir dans un éditeur hexadécimal. Le texte ressemble à un texte normal, et seul un détecteur connaissant le mécanisme peut, en théorie, retrouver la signature. Cette technique rappelle la stéganographie: l'information n'est pas visible dans le contenu lui-même, mais dissimulée dans la manière dont celui-ci est produit.
Sur le papier, c'est élégant. Dans la pratique, tout se complique.
Empreinte de génération, contribution réelle
Commençons par un exemple simple. J'écris :
J'ai démonté cette prise et découvert un BK7238.
Je demande à ChatGPT d'améliorer légèrement la formulation. Il me propose :
En démontant la prise, j'ai découvert un BK7238.
Qu'est-ce qui vient réellement de l'IA ? Ni le démontage, ni la découverte du composant, ni l'observation technique : tout cela reste humain. L'IA n'a modifié que la forme.
À l'autre extrême, quelqu'un peut demander :
Rédige-moi un article complet de 2 000 mots sur le piratage d'une prise connectée équipée d'un BK7238.
puis publier le résultat pratiquement tel quel.
Dans les deux cas, une IA est intervenue. Intellectuellement, ce sont pourtant deux démarches radicalement différentes, et c'est précisément ce qu'un watermark ne peut pas raconter. Il mesure une empreinte de génération. Il ne mesure pas la contribution réelle de l'IA au contenu.
Toute la suite de cet article découle de cette distinction.
Des traces fragiles : chaînes de modèles, synonymes, modèle local
Une chaîne sans mémoire
Prenons un scénario devenu banal : Claude → ChatGPT → publication.
Claude rédige une première version, qui peut porter la signature statistique d'Anthropic. Je demande ensuite à ChatGPT de la rendre plus fluide et de supprimer les répétitions, sans toucher au fond. Il régénère une partie des phrases selon ses propres probabilités: le watermark de Claude peut s'en trouver partiellement dégradé, tandis que celui d'OpenAI peut apparaître. Après une réécriture légère, les deux traces restent peut-être détectables. Après une réécriture plus profonde, seule la dernière signature peut subsister, ou aucune.
Ajoutons un petit Qwen installé localement : Claude → ChatGPT → Qwen. Ce troisième modèle n'a aucune raison de préserver les signatures précédentes. Il peut reformuler assez de mots pour dégrader les deux watermarks tout en conservant les mêmes idées, la même structure et les mêmes arguments. Au bout de la chaîne, le texte peut ne plus contenir aucune signature détectable, alors que son fond reste très largement issu de la première génération.
C'est l'une des limites les plus importantes du système : les watermarks statistiques ne construisent pas une chaîne de provenance.* Ils laissent des traces, et l'étape suivante peut les altérer.
Quelques synonymes suffisent
Il n'est même pas nécessaire de viser le watermark. Une consigne aussi ordinaire que « remplace certains mots par des synonymes sans modifier le sens » peut déjà fortement affaiblir le signal. OpenAI indique elle-même que, sur des passages de 400 tokens, remplacer environ 10 % des mots par des synonymes faisait chuter la détection d'environ 92 % à 66 %. À 25 % de remplacement, elle tombait autour de 17 %.3
Pas besoin d'attaque sophistiquée, de connaître le mécanisme ou d'utiliser un outil spécialisé : un workflow éditorial banal suffit. Demander à un LLM d'éviter les répétitions, de varier le vocabulaire, de raccourcir certains passages ou simplement de rendre le texte plus naturel peut altérer l'empreinte, sans aucune volonté de contourner quoi que ce soit. Et cette transformation peut aujourd'hui être réalisée par un modèle léger, sur un ordinateur domestique.
Mon propos n'est donc pas d'expliquer comment effacer un watermark. Il est de constater qu'un watermark peut s'affaiblir simplement parce qu'un texte a été retravaillé normalement.
L'inverse : un texte humain peut porter une trace
Le problème inverse me semble plus important encore.
J'écris entièrement un article. J'y passe plusieurs heures. Les expériences sont les miennes, les conclusions aussi: je sélectionne les informations, je construis le raisonnement, je décide de ce que je veux raconter. Mais je ne suis pas journaliste. Je peux savoir très clairement ce que je veux dire tout en étant moins à l'aise pour construire certaines phrases ou organiser un long texte. Je demande alors à une IA :
Peux-tu rendre ce paragraphe plus fluide ?
ou :
Cette partie est confuse. Aide-moi à mieux structurer mon raisonnement.
À partir de quel moment le texte devient-il un « texte IA » ? Après quelques corrections ? Une phrase reformulée ? Un paragraphe restructuré ? Une introduction proposée par le modèle ? Il n'existe évidemment pas de réponse simple.
Il faut également éviter l'excès inverse. Une tâche très spécifique, comme corriger la ponctuation ou quelques fautes, laisse au modèle très peu de liberté dans le choix des mots. Le signal statistique sera alors faible ou difficile à établir, précisément parce qu'il existe peu de variations possibles.
La question pertinente n'est donc pas de savoir si une IA est intervenue quelque part dans le workflow. Il faut savoir ce qu'elle a réellement fait.
L'IA, un spectre plutôt qu'un interrupteur
Nous parlons encore souvent de l'utilisation de l'IA comme d'une variable binaire : oui ou non. La réalité ressemble davantage à un spectre.
D'un côté :
Écris-moi un article de 1 500 mots sur ce sujet.
Quelques secondes plus tard, le contenu est publié presque tel quel. De l'autre, un auteur mène ses expériences, réfléchit au sujet, collecte l'information, construit son raisonnement, rédige un brouillon, puis demande à une IA d'améliorer certains passages. Les deux ont techniquement « utilisé ChatGPT ». Ce sont pourtant deux démarches profondément différentes.
La bonne question n'est donc pas seulement une IA est-elle intervenue ? mais qu'a-t-elle réellement fait ? A-t-elle produit les idées ? Le raisonnement ? Les faits ? La structure ? La prose ? A-t-elle proposé des contre-arguments ? Ou simplement rendu quelques phrases plus claires ? Cette information vaut bien davantage qu'un drapeau indiquant « contenu avec intervention IA ».
Et l'assistance humaine ?
Cette situation révèle aussi une étrange asymétrie. Depuis toujours, des auteurs font appel à des correcteurs, des éditeurs, des collaborateurs, des attachés de presse ou des ghostwriters, sans que le lecteur sache jusqu'où va leur intervention. Un texte peut être largement retravaillé par un tiers et rester publié sous le seul nom de son auteur.
Cela ne signifie pas qu'il faille renoncer à toute transparence sur l'IA. Mais pourquoi l'assistance rédactionnelle humaine pourrait-elle rester invisible, alors que l'assistance artificielle devrait devenir systématiquement suspecte? La comparaison n'est pas parfaite. Elle rappelle néanmoins que la notion d'auteur a toujours été plus complexe que « la personne qui a tapé chaque mot ».
Les LLM ne créent pas ce problème. Ils le rendent visible.
Watermark et détecteurs : deux outils, deux questions
Il faut ici distinguer deux choses que le débat public mélange facilement.
Le watermark est un signal introduit au moment de la génération par le fournisseur du modèle, et que celui-ci peut ensuite rechercher. Les détecteurs a posteriori, comme Pangram ou GPTZero, fonctionnent autrement : ce sont des classifieurs statistiques qui analysent un texte quelconque sans connaître son origine, et tentent d'y repérer des caractéristiques qu'ils associent aux textes générés par IA.
Les deux approches reposent sur des principes différents, avec des taux d'erreur différents. Mais leur usage social finit par se rejoindre : elles produisent un indice que quelqu'un devra interpréter. Et c'est là que les choses deviennent délicates.
Deux faux sens : Orélien et Hugo
« Écrit avec une IA » : le cas Thélyson Orélien
La polémique autour de Thélyson Orélien et de son roman C'était ça ou mourir illustre bien le problème. Le livre a été accusé d'avoir été largement produit avec l'aide de l'IA, notamment à partir d'analyses effectuées avec Pangram. L'auteur et ses éditeurs ont contesté ces accusations. Le roman avait pourtant déjà rencontré un large public — Le Monde évoquait 35 000 exemplaires vendus en cinq semaines —, remporté le prix du roman Fnac et figuré dans les sélections du Goncourt, du Renaudot et du Femina avant que la polémique n'éclate.4
Je ne prétends rien sur la manière dont il a réellement été écrit : je n'en sais rien, et un score ne suffit pas à le dire. Ce qui m'intéresse, c'est la question qui demeure même si une intervention importante de l'IA était un jour établie. Que voudrait dire exactement « écrit avec une IA » ? Que le modèle a rédigé certaines phrases ? Reformulé un manuscrit existant ? Proposé des passages ? Participé à la structure ? Produit une première version ensuite profondément retravaillée ? A-t-il imaginé les personnages, décidé de ce qu'il fallait conserver, écarté les mauvaises pistes, choisi le rythme, déterminé quand le livre était terminé ?
Un détecteur, aussi performant soit-il, ne permet pas de reconstituer cette chaîne. Et cela rappelle une évidence : l'utilisation d'un outil n'explique pas, à elle seule, la qualité d'une œuvre. Créer, c'est aussi sélectionner, évaluer, rejeter, ordonner et assumer le résultat.
Si produire un roman apprécié par des milliers de lecteurs et susceptible de retenir l'attention d'un jury se résumait à demander à un LLM « écris-moi un excellent roman », les candidats aux grands prix devraient déjà se compter par milliers. La boutade ne prouve évidemment rien sur le cas Orélien. Elle montre simplement que la question « une IA est-elle intervenue ? » ne suffit pas à expliquer une œuvre.
Quand Victor Hugo devient suspect
À l'autre extrême, des textes écrits bien avant ChatGPT ont déjà été signalés par certains détecteurs comme présentant des caractéristiques associées à une génération artificielle. Victor Hugo revient régulièrement parmi les exemples.
Il faut là encore rester prudent : tous les détecteurs ne se trompent pas. Dans un test récent, Clubic a confronté Pangram 4.0 et GPTZero 4.1m à dix textes en français. Demain, dès l'aube a été correctement classé comme humain par les deux outils, Pangram signalant toutefois une confiance limitée en raison de la brièveté du poème.5 Mais un autre article de Clubic rapporte également un test publié sur LinkedIn dans lequel Victor Hugo avait, cette fois, été signalé comme IA.6
Nous arrivons donc à une situation étonnante. D'un côté, un texte humain certain, antérieur à l'IA, peut être jugé statistiquement suspect par certains outils. De l'autre, un texte réellement généré ou largement retravaillé par IA peut devenir beaucoup plus difficile à identifier après paraphrase, traduction ou réécriture.
Les détecteurs ne racontent d'ailleurs pas tous la même histoire. Dans ce même test Clubic, un article humain fortement réécrit par ChatGPT était classé « Mixed / AI Detected » par Pangram (38 % IA / 62 % humain), alors que GPTZero le jugeait humain à 98 % avec une forte confiance. Sur un autre texte intégralement généré par ChatGPT, Pangram indiquait 100 % IA tandis que GPTZero donnait un résultat incertain : 40 % IA, 1 % mixte et 59 % humain.5 Cela ne signifie pas que ces outils sont mauvais. Cela signifie surtout que la question qu'on leur demande de trancher est extraordinairement difficile.
Un détecteur voit le texte final, pas son histoire
C'est peut-être le point central. Le détecteur ne voit ni le premier brouillon, ni l'historique du document, ni les prompts, ni les corrections humaines, ni les passages supprimés, ni les propositions refusées, ni les recherches ou les expériences réalisées, ni les échanges successifs avec plusieurs modèles. Il ne voit qu'un objet : le texte final. Et il tente d'en déduire son histoire.
Or des histoires très différentes peuvent aboutir à des textes statistiquement proches :
- un texte humain profondément reformulé par ChatGPT ;
- un texte de ChatGPT profondément réécrit par un humain ;
- un texte de Claude passé dans ChatGPT puis dans Qwen ;
- un texte humain traduit puis retraduit par plusieurs modèles ;
- un texte entièrement généré par IA, puis modifié juste assez pour perdre sa signature.
Le détecteur essaie en quelque sorte de reconstruire le film à partir de sa dernière image. Il peut y trouver des indices. Il ne peut pas nécessairement raconter ce qui s'est réellement passé.
Détecter une intervention n'est pas établir une paternité
C'est là, à mes yeux, que se trouve le principal danger. Un outil peut produire une information technique :
Ce passage contient probablement une signature associée à un modèle OpenAI.
Le lecteur risque d'en déduire :
ChatGPT a écrit ce texte.
Ce n'est pas la même affirmation. Le watermark peut indiquer qu'un modèle a généré ou traité suffisamment de texte pour laisser une trace. Il ne dit pas qui a eu les idées, qui a effectué la recherche, qui a mené les expériences, qui a pris les décisions éditoriales, quelle proportion du travail intellectuel est humaine, ni qui assume la responsabilité du contenu.
OpenAI précise elle-même qu'un watermark ne mesure pas la contribution humaine, n'établit ni propriété ni responsabilité, n'identifie pas l'utilisateur et ne vérifie pas l'exactitude du contenu. Elle ajoute que l'absence de watermark détecté ne prouve pas qu'un humain a écrit le texte.7 Anthropic formule une limite très proche : son watermark peut seulement indiquer que Claude a probablement été impliqué dans le contenu ; il ne peut pas distinguer « Claude a écrit ceci » de « Claude a fortement édité ceci », et ne dit rien de l'auteur ou de la propriété du texte.8
Le watermark peut détecter une intervention. Il ne peut pas déterminer la paternité.
Qui vérifiera les signatures ?
Une autre difficulté apparaît rapidement. OpenAI développe textGrain, Anthropic a son propre système, d'autres fournisseurs feront autre chose. Chaque mécanisme possède ses paramètres, sa clé et son détecteur. Nous n'avons donc pas un standard universel capable de répondre simplement « ce texte contient une signature IA ». Nous avons plutôt :
OpenAI retrouve un signal OpenAI.
Anthropic retrouve un signal Anthropic.
Et si les deux modèles sont intervenus ? S'ils donnent des résultats contradictoires ? Si un troisième modèle a ensuite reformulé le texte ? Si le détecteur d'un fournisseur est positif alors qu'un outil tiers ne trouve rien ? Qui décide alors de ce que cela signifie ?
Une fois encore, la technologie produit une information. Elle ne produit pas son interprétation.
Plagiat, scores et ostracisme algorithmique
Les logiciels anti-plagiat nous ont déjà appris les dangers d'une confiance excessive dans un score. Un outil détecte une similitude, mais il faut ensuite l'interpréter : citation correctement référencée, formulation technique inévitable, texte législatif, véritable copie ? Le score n'est que le début de l'analyse.
Avec le plagiat, on peut au moins mettre les passages côte à côte : voici le texte publié, voici la source, voici ce qui correspond. Avec un détecteur générique de contenu IA, la « preuve » devient beaucoup plus abstraite :
Ce texte présente des caractéristiques statistiques associées aux textes générés par IA.
Cela ne rend pas ces outils inutiles. Cela signifie simplement qu'ils doivent rester ce qu'ils sont : des indicateurs, pas des juges.
Ce qui m'inquiète davantage, c'est le moment où un professeur, un éditeur ou un employeur voit apparaître « 87 % de probabilité que ce texte soit généré par IA ». Combien prendront réellement le temps de comprendre ce que ce chiffre mesure ? La tentation est grande d'en faire un verdict : triche, fraude, paresse, contenu artificiel. Or le score ne dit rien de tout cela.
Un étudiant peut avoir entièrement rédigé son travail avant de demander à une IA d'améliorer quelques formulations. Un journaliste peut lui faire reformuler une introduction. Un chercheur peut faire traduire son propre texte. Un auteur peut utiliser l'IA comme un éditeur disponible à toute heure. Et, inversement, quelqu'un peut faire produire pratiquement tout un texte par un modèle puis le transformer suffisamment pour semer certains détecteurs.
Traiter toutes ces situations de la même manière reviendrait à instaurer une forme d'ostracisme fondé sur un indicateur technique mal compris. Les faux positifs rendent cette perspective encore plus préoccupante.
Images, décisions : lorsque la vraie question se déplace
Pour une image réaliste, le problème est différent
Je suis pourtant très favorable à la transparence lorsque l'IA peut tromper notre perception du réel. Une vidéo photoréaliste montrant un événement qui n'a jamais eu lieu, ou une fausse photographie réaliste d'une personne, d'un conflit ou d'une catastrophe, devrait être clairement identifiée comme artificielle ou manipulée. Dans ce cas, l'indication « généré par IA » répond à une question essentielle : ce que je regarde s'est-il réellement produit ?
Pour une infographie, c'est différent. Personne ne prend un schéma montrant des tokens, des neurones ou une puce électronique pour la captation d'un événement réel. L'outil utilisé pour fabriquer l'illustration m'importe alors beaucoup moins que la véracité de ce qu'elle montre.
La question pertinente pourrait donc être : l'utilisation de l'IA modifie-t-elle ce que le public croit être réel ?
Et pour les décisions ?
Le sujet devient plus intéressant encore lorsqu'aucun contenu n'est généré. Une entreprise utilise un modèle pour classer des CV. Une banque l'utilise pour évaluer un dossier. Un médecin consulte une recommandation produite par IA. Un responsable compare plusieurs stratégies avec un LLM avant de décider. Quel watermark révélera ces interventions ? Aucun.
La décision finale peut être rédigée entièrement par un humain alors que l'IA a joué un rôle bien plus important que dans la reformulation d'un paragraphe. Nous dépensons beaucoup d'énergie à repérer l'IA dans les productions visibles, alors que certaines de ses interventions les plus significatives ont lieu en amont. Dans ces situations, ce dont nous avons besoin n'est pas d'un watermark mais d'une véritable traçabilité du processus de décision.
De la transparence, oui, mais laquelle ?
Il est légitime de vouloir davantage de transparence sur l'utilisation de l'intelligence artificielle. Je serais moi-même mal à l'aise face à quelqu'un qui ferait produire des dizaines d'articles par un modèle tout en laissant croire qu'ils résultent de recherches et de réflexions personnelles.
Mais cette transparence devrait probablement porter sur le processus, pas seulement sur la présence ou l'absence d'une empreinte. Il y a un monde entre :
Article entièrement généré par IA.
et :
L'auteur a utilisé une IA pour la recherche, la confrontation d'idées, la correction et l'assistance rédactionnelle. Les expériences, analyses et choix éditoriaux restent les siens.
La seconde information dit réellement quelque chose au lecteur. Un watermark invisible, beaucoup moins.
Alors, qui a écrit ce texte ?
C'est finalement la question que textGrain m'a amené à me poser. Si j'apporte une expérience personnelle, une réflexion, des arguments, des objections et des choix éditoriaux, mais qu'un outil m'aide à les exprimer plus clairement, suis-je encore l'auteur ? À mes yeux, oui.
Cela ne signifie pas que l'intervention de l'outil doit être cachée. Cela signifie que l'auteur d'une idée et l'auteur de chaque mot utilisé pour l'exprimer ne sont pas nécessairement la même personne. C'était déjà vrai avant l'intelligence artificielle. Les LLM n'ont fait que rendre cette frontière plus visible, et peut-être plus inconfortable.
Un grain de sable ?
Des systèmes comme textGrain partent d'une intention compréhensible : apporter davantage de transparence dans un monde où produire du contenu synthétique est devenu trivial. Le risque est qu'un signal technique soit rapidement chargé d'une signification qu'il n'a pas.
Un watermark peut dire :
Un modèle a probablement laissé une trace dans ce texte.
Il ne peut pas répondre à :
Qui a réellement pensé ce texte ? Quelle part du travail est humaine ? L'IA a-t-elle remplacé l'auteur ou simplement aidé celui-ci ? Ce contenu mérite-t-il moins de confiance ?
Ces questions demandent du contexte, du jugement et sans doute une nouvelle manière de décrire nos méthodes de création.
La transparence exige du contexte, pas seulement un signal.
Et si nous l'oublions, le grain censé rendre la machine plus transparente pourrait bien finir par se glisser dans ses rouages.
Sources
Note de processus : les idées, les exemples, les expériences et la thèse de cet article sont ceux de l'auteur. Une IA a été utilisée pour en analyser la structure, fluidifier la rédaction et rassembler les sources.
Footnotes
-
OpenAI, Our approach to EU text provenance rules, 5 octobre 2026. OpenAI annonce un déploiement progressif du watermark textGrain dans les sorties ChatGPT et Codex éligibles dans l'Union européenne, ainsi qu'un accès initial au détecteur limité aux chercheurs et organisations expertes approuvés. https://openai.com/index/eu-text-provenance/ ↩
-
Anthropic, How Claude's text watermark works, 14 août 2026, mise à jour le 1er septembre 2026. Anthropic décrit son watermark statistique pour Claude, précise qu'il n'ajoute aucun caractère caché et présente les modalités de vérification. https://www.anthropic.com/news/claude-text-watermark ↩
-
OpenAI, Our approach to EU text provenance rules, section « How our watermarking works and performs ». Sur des passages anglais de 400 tokens, le remplacement de 10 % des mots par des synonymes fait passer la détection d'environ 92 % à 66 % ; avec 25 % de remplacement, elle tombe à 17 %. https://openai.com/index/eu-text-provenance/ ↩
-
Le Monde, « Thélyson Orélien accusé d'avoir utilisé l'IA pour son livre “C'était ça ou mourir” », 22 septembre 2026. L'article rapporte les accusations fondées notamment sur Pangram, la contestation de l'auteur et de ses éditeurs, environ 35 000 exemplaires vendus en cinq semaines, le prix du roman Fnac et les sélections Goncourt, Renaudot et Femina. https://www.lemonde.fr/pixels/article/2026/09/22/thelyson-orelien-accuse-d-avoir-utilise-l-ia-pour-son-livre-c-etait-ca-ou-mourir_6780300_4408996.html ↩
-
Clubic, « Affaire Thélyson Orélien : que prouve vraiment un score à 97 % IA ? Nous avons fait le test », 4 octobre 2026. Le test compare Pangram 4.0 et GPTZero 4.1m sur dix textes français, dont des textes humains, des textes intégralement générés par ChatGPT, des cas hybrides et Demain, dès l'aube. https://www.clubic.com/dossier-632419-affaire-thelyson-orelien-que-prouve-vraiment-un-score-a-97-ia-nous-avons-fait-le-test.html ↩ ↩2
-
Clubic, « IA & littérature : après l'affaire Orélien, les auteurs classiques sont soumis au détecteur, et c'est surprenant », 26 septembre 2026. L'article rapporte notamment une expérience publiée sur LinkedIn dans laquelle Victor Hugo avait été signalé comme IA, alors que Maupassant et Baudelaire étaient classés humains par Pangram. https://www.clubic.com/actualite-631387-ia-litterature-apres-l-affaire-orelien-les-auteurs-classiques-sont-soumis-au-detecteur-et-c-est-surprenant.html ↩
-
OpenAI, Our approach to EU text provenance rules, section « What a text watermark doesn't tell you ». OpenAI précise qu'un watermark ne mesure pas la contribution humaine, n'établit ni propriété ni responsabilité, n'identifie pas l'utilisateur, ne vérifie pas l'exactitude et que son absence ne prouve pas une origine humaine. https://openai.com/index/eu-text-provenance/ ↩
-
Anthropic, How Claude's text watermark works, sections « What does a watermark actually prove? » et « Does this change who owns a given output, or who is legally responsible for it? ». Anthropic indique que le watermark ne peut que montrer que Claude a probablement été impliqué, sans distinguer rédaction et édition lourde, ni établir l'auteur ou la propriété. https://www.anthropic.com/news/claude-text-watermark ↩
Commentaires
Aucun commentaire pour le moment.
Ajouter un commentaire