Kiss, votre compagnon virtuel propulsé par une IA locale
Kiss, un assistant RAG entièrement auto-hébergé pour explorer GREY/WIRED. Retour sur cette expérience d’IA locale, ses choix techniques, ses performances et ses limites.
Tout est parti d'un besoin assez banal : ajouter une fonction de recherche à GREY/WIRED.
Le blog commence à accumuler suffisamment d'articles, de projets et de petites réflexions pour qu'il ne soit plus toujours évident de retrouver une information précise. Un moteur de recherche classique aurait parfaitement fait l'affaire. Quelques mots-clés, une liste de résultats et le problème était probablement réglé.
Mais j'avais une autre idée en tête.
Dans un précédent article consacré à mon modèle d'IA local, j'expliquais pourquoi je trouvais les modèles relativement modestes particulièrement intéressants lorsqu'ils étaient intégrés à des systèmes plus larges. Pas pour rivaliser avec les grands services d'intelligence artificielle, mais pour remplir des fonctions concrètes, avec les bonnes informations et les bons outils.
J'avais déjà expérimenté plusieurs usages sur mon infrastructure personnelle. Le problème, c'est que je ne peux pas vraiment inviter les visiteurs du blog à interagir avec mon installation domotique ou mes autres outils internes pour leur montrer ce que cela donne.
En revanche, je pouvais leur proposer d'interroger directement GREY/WIRED.
L'idée était de remplacer le traditionnel champ de recherche par un assistant capable de comprendre une question, de retrouver les publications pertinentes et de formuler une réponse en s'appuyant sur leur contenu.
C'est ainsi qu'est né Kiss.
Pourquoi Kiss ? Parce que c'est aussi le nom de mon Weimaraner, mon compagnon bien réel, qui m'« assiste » au quotidien… quand il le veut bien. :-)
J'espère simplement que son pendant virtuel se montrera un peu moins facétieux !
Rien de révolutionnaire. Les briques techniques existaient déjà et je suis loin d'être le premier à expérimenter un assistant documentaire. Mais appliquer ce principe à un blog personnel, avec un modèle entièrement auto-hébergé, me semblait une curiosité intéressante.
Et, accessoirement, une bonne excuse pour poursuivre mes expériences.
J'allais aussi découvrir qu'en matière de recherche documentaire, il vaut mieux comparer les solutions sur ses propres contenus que suivre aveuglément la tendance du moment.
Un moteur de recherche qui sait aussi répondre
Une recherche classique retrouve des documents. Un assistant documentaire essaie d'aller un peu plus loin.
Si je cherche des informations sur Zigbee, un moteur traditionnel me présentera une liste d'articles contenant les termes correspondants. Kiss peut, lui, recevoir une question comme « Quelle différence entre ZHA et Zigbee2MQTT ? », retrouver les publications pertinentes, puis en proposer une synthèse avec des liens vers les sources.
C'est le principe du RAG, pour Retrieval-Augmented Generation, ou génération augmentée par récupération d'informations.1
Derrière ce nom un peu intimidant, le fonctionnement est assez simple :
- Je constitue un corpus à partir des publications du site.
- Lorsqu'un visiteur pose une question, un moteur de recherche sélectionne les documents ou passages susceptibles de contenir la réponse.
- Ces informations sont transmises au modèle d'IA avec la question.
- Le modèle rédige une réponse et peut renvoyer vers les publications concernées.
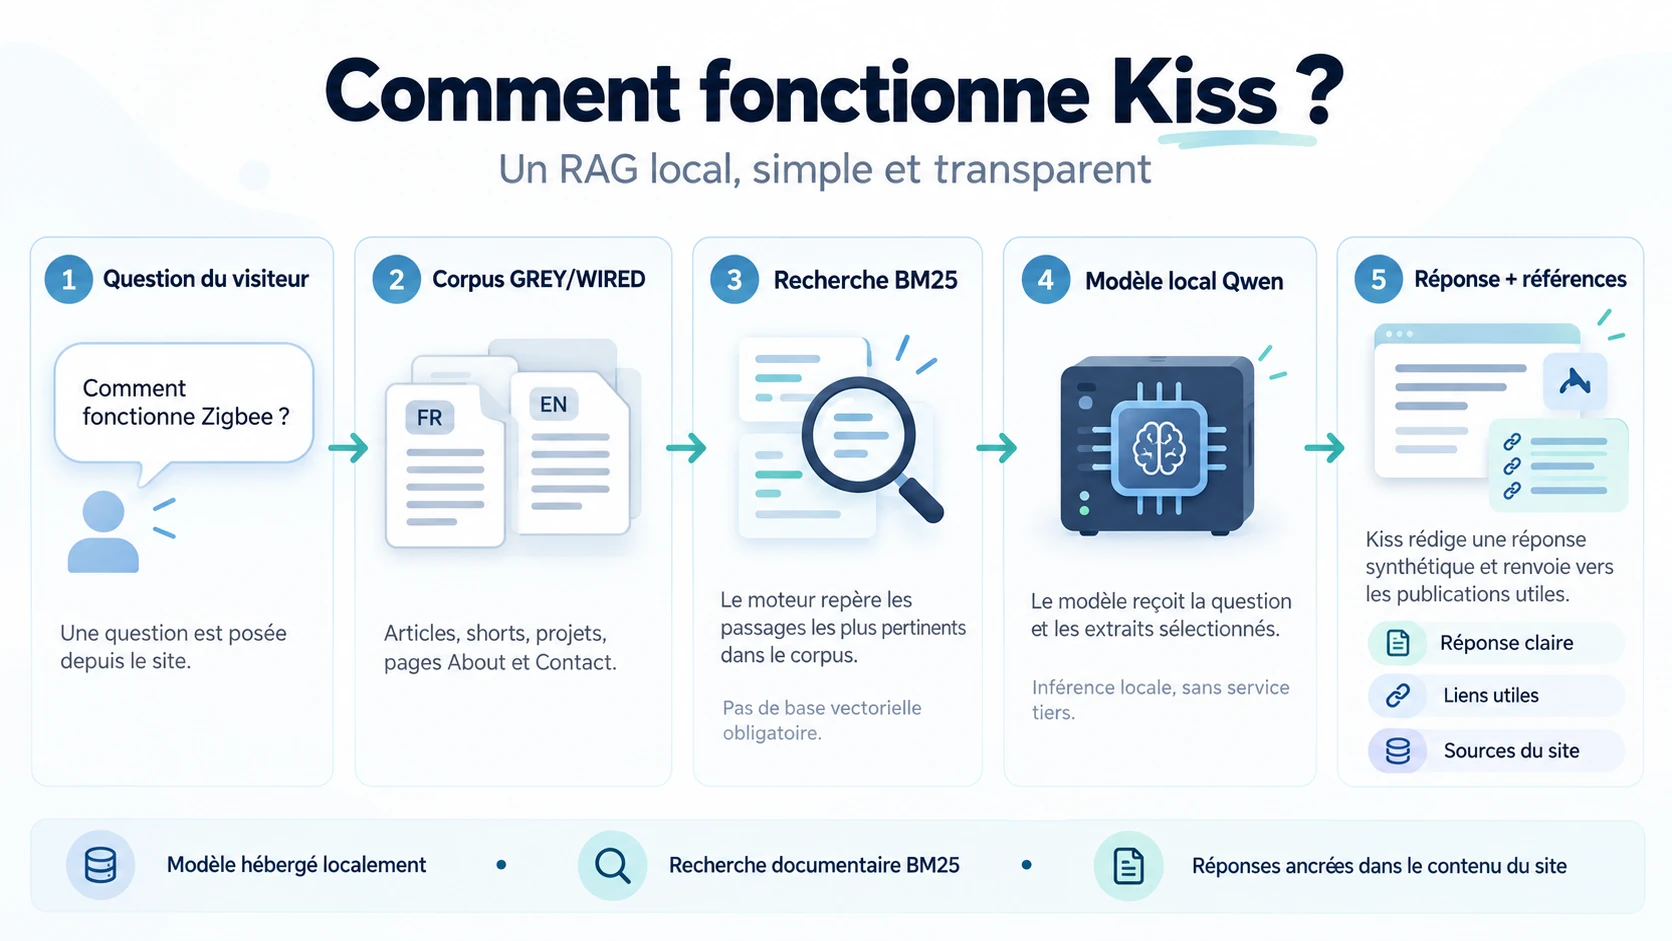
Le point important est que je n'ai pas réentraîné Qwen avec les articles du blog. Le modèle utilise les informations qu'on lui fournit au moment de répondre.
Cela permet notamment d'actualiser les connaissances de Kiss lorsque je publie un nouvel article, sans devoir modifier les paramètres du modèle.
Pour l'instant, le corpus se limite aux publications et aux pages institutionnelles de GREY/WIRED, en français et en anglais. Mais le concept pourrait être appliqué à des ressources beaucoup plus variées.
Un site de documentation technique pourrait combiner des pages web, des notices et des PDF. Un assistant pourrait non seulement répondre à une question, mais aussi orienter vers une fiche à consulter ou un document à télécharger.
Kiss ne fait pas tout cela aujourd'hui. C'est simplement une illustration de la manière dont le même principe pourrait être transposé ailleurs.
Retrouver les bons documents : moins évident qu'il n'y paraît
Une fois le principe du RAG posé, une question devient essentielle : comment retrouver les informations réellement pertinentes ?
C'est une étape souvent moins spectaculaire que la génération de texte, mais elle est déterminante. Un modèle peut parfaitement rédiger une réponse convaincante à partir des mauvais documents. La fluidité de son discours ne garantit absolument pas sa justesse.
Pour Kiss, j'ai donc décidé de comparer plusieurs méthodes de recherche documentaire avant de choisir celle que j'utiliserais en production. Mon objectif n'était pas de retenir la technologie la plus à la mode, mais celle qui fonctionnerait le mieux sur les publications et les questions de mon blog.
BM25 : une méthode ancienne, mais loin d'être dépassée
BM25 recherche les mots de la question dans les documents, mais ne se contente pas de les compter : il donne notamment davantage de poids aux termes rares dans le corpus, tient compte de leur fréquence et ajuste les scores selon la longueur des textes. Cette méthode s'inscrit dans une longue tradition de recherche documentaire, bien antérieure à l'engouement actuel pour les modèles de langage.2
Prenons une question contenant « ESP32 », « Thread » et « Border Router ». Si ces termes figurent dans le titre et le contenu d'un article, BM25 a de bonnes raisons de le faire remonter.
C'est particulièrement intéressant sur un blog technique, où les noms de composants, les protocoles et les références exactes ont souvent beaucoup d'importance.
Mais deux formulations peuvent désigner la même chose sans partager beaucoup de vocabulaire. Inversement, un document peut contenir tous les bons mots sans apporter la réponse recherchée. C'est ce qui m'a poussé à tester une recherche sémantique.
E5-small : représenter les documents autrement
E5-small cherche des proximités de sens : un modèle transforme les questions et les documents en vecteurs numériques, et rapproche ceux qui parlent du même sujet, même lorsqu'ils utilisent des mots différents. Ces représentations sont appelées embeddings.
Pour cette expérience, j'ai utilisé multilingual-e5-small, un modèle capable de produire ces représentations dans plusieurs langues.3 Pour les comparaisons finales, j'ai retenu une représentation moyenne des différentes parties de chaque document, désignée E5 mean dans les résultats.
RRF : l'union fait-elle vraiment la force ?
Puisque BM25 et E5-small possèdent des qualités complémentaires, la tentation est naturelle : pourquoi ne pas fusionner leurs résultats ?
Avec RRF, un document qui apparaît haut dans les deux classements reçoit un bon score combiné. Mais la méthode tient compte des positions, pas de l'écart réel entre les scores des moteurs.4
Autrement dit, combiner deux approches ne garantit pas un meilleur classement pour chaque question. C'est précisément ce que les tests allaient mettre en évidence.
Comment mesurer la pertinence d'une recherche ?
Pour comparer ces méthodes, j'ai constitué des jeux de questions accompagnés de jugements sur la pertinence des publications.
Chaque document pouvait recevoir un grade pour une question donnée :
| Grade | Signification |
|---|---|
| 0 | Le document ne répond pas utilement à la question. |
| 1 | Il apporte un complément pertinent, mais pas une réponse directe. |
| 2 | Il répond directement à la question. |
Un même article peut évidemment être très pertinent pour une question et parfaitement inutile pour une autre.
Pour mesurer la qualité des classements, je voulais répondre à trois questions : ai-je retrouvé les documents utiles ? Le premier résultat est-il pertinent ? Les meilleurs documents apparaissent-ils dans le bon ordre ?
J'ai utilisé trois indicateurs classiques pour cela. Leurs noms sont un peu rébarbatifs, mais leur logique est accessible.
Recall@3 : combien de documents utiles ai-je retrouvés ?
Le Recall@3, ou rappel parmi les trois premiers résultats, mesure la proportion des documents pertinents retrouvés dans les trois premières positions.
Imaginons que quatre publications soient utiles pour répondre à une question. Si le moteur en retrouve deux parmi ses trois premiers résultats, le Recall@3 vaut 2/4, soit 50 %.
Cette métrique mesure la couverture documentaire. Elle ne dit pas si le meilleur document est arrivé en premier.
MRR : à quelle position apparaît le premier résultat utile ?
Le Mean Reciprocal Rank s'intéresse à la position du premier document pertinent.
S'il apparaît en première position, le score vaut 1. En deuxième position, 0,5. En troisième, environ 0,33. Le MRR est la moyenne de ces valeurs sur les questions évaluées.
Mais il existe une subtilité : dans mes tests, un document de grade 1 et un document de grade 2 comptent tous deux comme pertinents. Le MRR ne distingue donc pas une réponse directe d'un simple complément, pour peu qu'ils apparaissent à la même position.
nDCG@5 : les meilleurs documents sont-ils bien classés ?
Le Normalized Discounted Cumulative Gain tient compte à la fois de la position des cinq premiers documents et de leur degré de pertinence.
Un document de grade 2 vaut davantage qu'un document de grade 1, et une réponse utile placée en tête vaut davantage que la même réponse en cinquième position. Le score est normalisé par rapport à un classement idéal.
C'est donc une façon de mesurer la qualité de l'ordre des résultats, et pas seulement la présence de documents utiles.
Aucune de ces métriques ne raconte toute l'histoire. Et elles n'évaluent pas directement les réponses rédigées par Qwen : elles mesurent le travail du moteur de recherche situé en amont.
Ce que les tests ont réellement donné
J'ai d'abord comparé BM25 et E5-small sur un jeu historique de 16 questions, dont 14 possédaient une réponse documentaire pertinente.
| Méthode | Recall@3 | MRR | nDCG@5 |
|---|---|---|---|
| BM25 | 87,38 % | 100 % | 95,90 % |
| E5-small | 86,43 % | 96,43 % | 93,84 % |
Sur cette première campagne, BM25 obtenait de meilleurs scores moyens sur les trois indicateurs.
Le MRR de 100 % mérite une précision : pour chacune des 14 questions possédant une réponse, le premier document proposé par BM25 était au moins pertinent. Pas nécessairement idéal, mais utile.
J'ai ensuite poursuivi l'expérience avec RRF. Une nouvelle campagne de confirmation, distincte de la précédente, utilisait 32 questions, dont 26 disposaient d'au moins une réponse documentaire pertinente.
| Méthode | Recall@3 | MRR | nDCG@5 |
|---|---|---|---|
| BM25 | 84,82 % | 91,67 % | 87,61 % |
| E5-small | 81,32 % | 95,19 % | 88,50 % |
| RRF | 83,79 % | 97,12 % | 91,41 % |
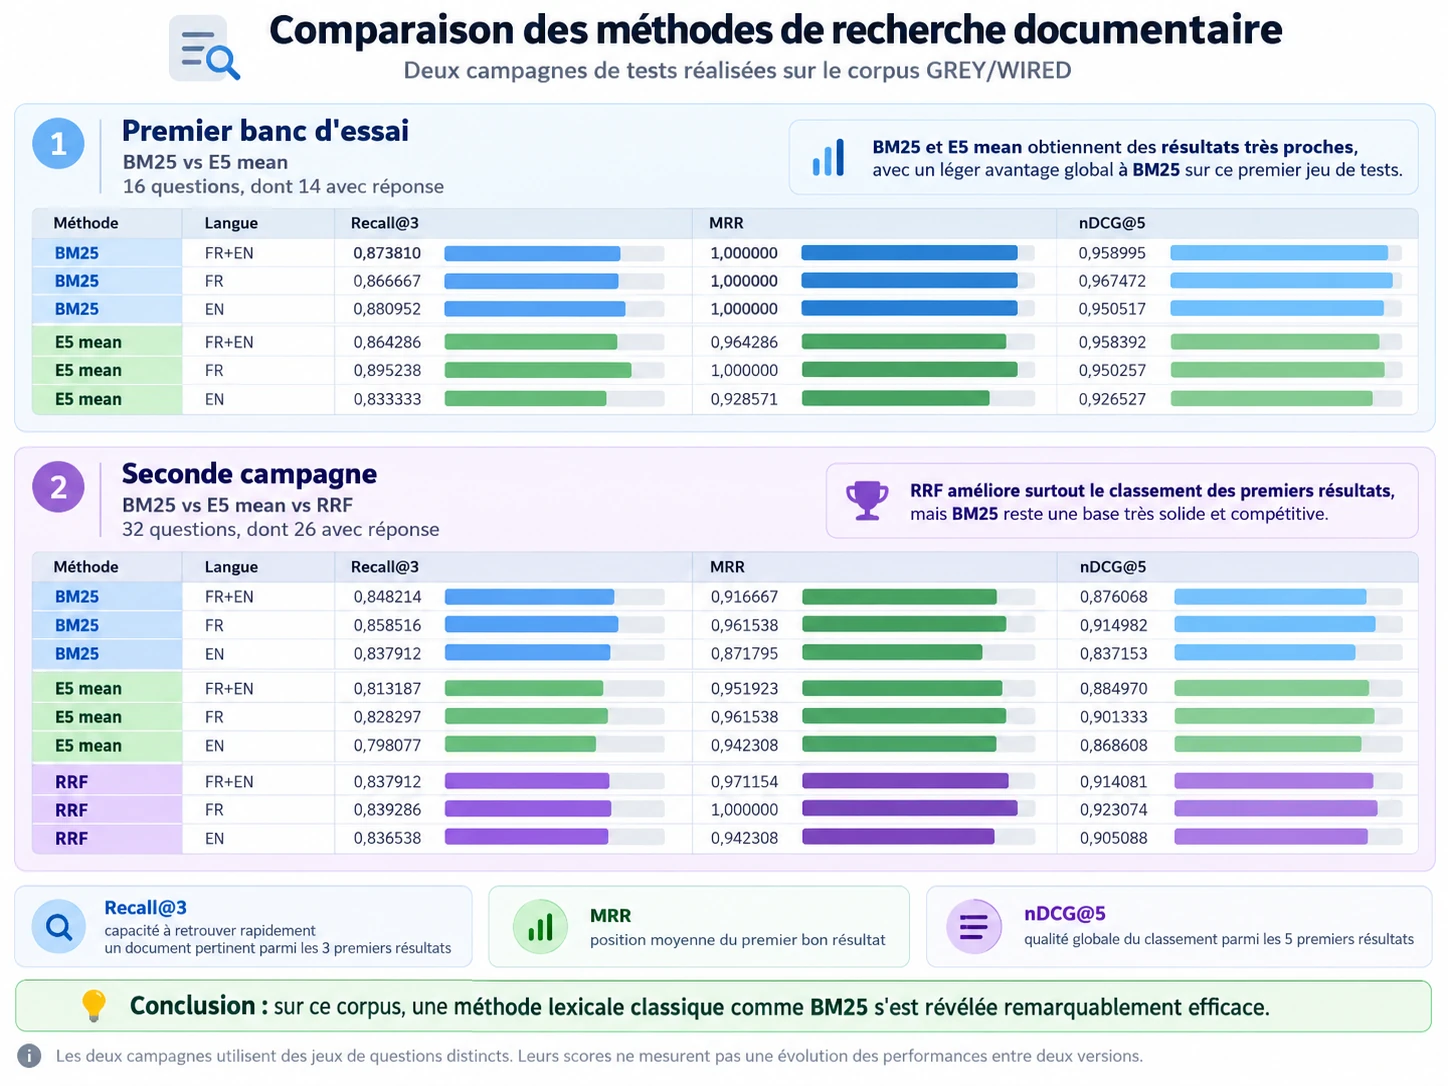
Cette fois, la conclusion était moins évidente.
RRF améliorait sensiblement la position du premier résultat pertinent et la qualité moyenne des cinq premiers documents. BM25 conservait un léger avantage sur le rappel parmi les trois premiers.
À première vue, il aurait été tentant de retenir RRF.
Mais j'avais défini des critères d'adoption avant d'examiner les résultats. Je voulais notamment éviter qu'une publication répondant directement à une question soit remplacée en première position par un document seulement complémentaire.
Or, c'est arrivé.
Sur les 26 questions positives, RRF faisait passer le nombre de premières réponses non pertinentes de quatre à une, et celui des premières réponses directement pertinentes de 19 à 21. Ce sont de véritables améliorations. Mais deux excellentes premières réponses de BM25 étaient dégradées.
Les moyennes progressaient, sans que chaque question bénéficie du changement.
Deux exemples plus parlants que les moyennes
Une question demandait si le router d'un réseau Zigbee correspondait au routeur Internet ou à un rôle assuré par certains appareils connectés.
BM25 plaçait en premier un article consacré à la construction d'un Thread Border Router avec des ESP32. Le mot « router » favorisait un document qui ne répondait pas directement à la question.
E5-small retrouvait, lui, immédiatement l'article « Zigbee sans (trop) se compliquer la vie ». RRF plaçait également ce dernier en tête. C'était un vrai succès de la recherche sémantique.
Mais une autre question, consacrée aux activités permettant d'occuper mentalement un Weimaraner, a produit l'effet inverse.
BM25 plaçait d'abord le projet « Mission : occuper un Weimaraner », directement pertinent. E5-small préférait un article complémentaire sur la relation entre le chien et son maître.
RRF donnait exactement le même score aux deux documents, puisque leurs rangs étaient inversés entre les deux moteurs. Une règle de départage des égalités a alors placé le complément devant la réponse directe.
Le Recall@3 et le MRR restaient pourtant parfaits pour cette question.
C'est le genre de détail qui montre pourquoi il faut examiner les cas individuels, et pas uniquement les moyennes.
J'ai finalement conservé BM25 comme moteur de recherche par défaut.
Pas parce qu'il serait intrinsèquement supérieur à la recherche vectorielle. Mes essais montrent clairement que ce n'est pas toujours le cas. Mais parce que la configuration hybride testée ne remplissait pas tous mes critères et que BM25 présentait l'avantage supplémentaire d'être simple, léger et adapté à mon corpus.
Il faut aussi relativiser la portée de cette expérience : les campagnes portent sur quelques dizaines de questions et un nombre limité de publications. Les variantes françaises et anglaises correspondent souvent aux mêmes intentions ; les annotations de la confirmation ont été préparées avec l'aide d'une IA, puis partiellement revues et arbitrées humainement, sans double validation humaine exhaustive.
Ces chiffres constituent donc un retour d'expérience sur mon corpus, pas un verdict universel sur les moteurs de recherche.
Un RAG sans base de données vectorielle ?
Cette expérience m'a amené à m'interroger sur une idée très répandue : dès qu'on parle de RAG, les embeddings et les bases vectorielles semblent presque incontournables.
Il existe de bonnes raisons à leur popularité. La recherche sémantique peut retrouver des documents sans correspondance exacte de vocabulaire, tandis que les bases vectorielles proposent des outils efficaces pour stocker, indexer et interroger de grandes collections de vecteurs.
De nombreux frameworks et services spécialisés proposent d'ailleurs directement cette architecture, ce qui en fait un point de départ assez naturel.
Mais il faut distinguer recherche vectorielle et base de données vectorielle.
La première consiste à comparer des représentations numériques. La seconde est une infrastructure qui permet de les organiser et de les interroger.
Sur un petit corpus, une simple matrice en mémoire peut suffire. C'est exactement ce que j'ai fait lors de mes essais avec E5-small, en utilisant NumPy, sans base de données vectorielle spécialisée.
Et un RAG n'exige même pas nécessairement des embeddings : il associe récupération d'informations et génération, quelle que soit la méthode employée pour retrouver les documents.
Je ne tire évidemment pas de cette expérience la conclusion que les bases vectorielles seraient inutiles. Sur des corpus plus importants, aux formulations variées ou aux besoins complexes, elles peuvent parfaitement avoir leur place.
Mais je trouve intéressant qu'une méthode bien plus ancienne et moins spectaculaire ait finalement répondu à mon besoin.
Une technologie populaire n'est pas nécessairement la meilleure réponse à tous les problèmes.
Cette expérience m'a surtout rappelé qu'il n'existe pas de recette miracle pour construire un RAG. Le choix du moteur dépend de la nature du corpus, de son volume, du vocabulaire employé, des questions auxquelles on souhaite répondre et du niveau de pertinence attendu.
Lorsqu'on travaille sur un corpus documentaire défini, il me semble donc judicieux de consacrer un peu de temps à comparer différentes approches plutôt que d'adopter automatiquement celle qui domine les tutoriels du moment. L'effort d'évaluation peut naturellement rester proportionné à la taille et à l'importance du projet.
Dans mon cas, il m'a conduit à conserver BM25. Sur un autre corpus, avec d'autres questions, le résultat pourrait parfaitement être différent.
Pourquoi tout héberger moi-même ?
La réponse courte serait : pourquoi pas ?
Je disposais déjà d'un serveur équipé d'une NVIDIA RTX 3070 Ti avec 8 Go de VRAM. J'y faisais fonctionner un modèle Qwen d'environ 9 milliards de paramètres, quantifié pour tenir sur ce matériel.
J'avais donc une bonne partie des composants nécessaires.
J'aurais pu utiliser une API d'IA commerciale. Cela aurait probablement simplifié certains aspects de la mise en œuvre. Mais cela aurait aussi retiré une bonne partie de l'intérêt de l'expérience : je voulais justement voir jusqu'où je pouvais aller avec mon propre matériel.
Kiss utilise donc mon infrastructure pour la recherche documentaire comme pour la génération des réponses. Aucun service d'inférence externe n'est sollicité lorsqu'un visiteur lui pose une question.
Ce choix m'offre une certaine indépendance : je peux conserver une version précise du modèle, modifier mes composants, reconstruire mon corpus et décider moi-même des évolutions.
Il ne rend évidemment pas le système gratuit. Le matériel consomme de l'électricité, doit être entretenu, et les éventuelles pannes sont mon problème. Je reste également dépendant de logiciels et de modèles développés par d'autres.
Mais je ne suis pas tributaire d'une API commerciale pour produire les réponses. Et pour une expérience personnelle, cette liberté me plaît.
Huit gigaoctets de VRAM, et une réponse qui arrive rapidement
L'un des aspects que je souhaitais particulièrement montrer aux visiteurs concerne les performances.
On pourrait imaginer qu'un modèle local de neuf milliards de paramètres, exécuté sur une carte graphique de 8 Go, produise ses réponses péniblement.
Ce n'est pas ce que j'observe.
Lors des tests réalisés sur Kiss, la génération atteignait environ 76 tokens par seconde. Un token correspond grossièrement à un fragment de texte ; ce débit permet un affichage particulièrement fluide.
Les requêtes complètes mesurées ont pris entre 2,5 et 11,2 secondes, suivant les scénarios. Le premier événement du flux arrivait en moins de quatre secondes dans les essais concernés, même si cet événement ne correspondait pas nécessairement au premier caractère visible.
Ces résultats sont d'autant plus intéressants que le processeur de mon serveur est loin d'être adapté à ce type de charge.
On pourrait penser que, puisque l'inférence est principalement assurée par la carte graphique, le processeur n'a plus beaucoup d'importance. Ce serait oublier qu'il intervient toujours dans différentes étapes du traitement : préparation des requêtes, recherche documentaire, tokenisation, orchestration et certaines opérations du moteur d'inférence.
Cela ne signifie pas qu'un CPU plus rapide augmentera nécessairement la vitesse de génération des tokens dans les mêmes proportions. Lorsque le GPU constitue le facteur limitant, les gains peuvent être modestes sur cette partie du traitement.
En revanche, une amélioration du processeur pourrait réduire certaines latences et améliorer la réactivité globale, particulièrement lors de la préparation des réponses.
Une mise à niveau du CPU est prévue, et il sera intéressant de reprendre les mêmes mesures après son remplacement pour déterminer les gains réels.
Pour l'instant, malgré cette configuration loin d'être optimale, les performances me semblent tout à fait satisfaisantes pour l'usage auquel Kiss est destiné.
La fluidité du texte et le délai avant le début de la réponse n'ont, dans ce contexte, pas grand-chose à envier à l'expérience proposée par les services d'IA externes.
Cela ne signifie évidemment pas que mon Qwen rivalise avec les meilleurs modèles commerciaux sur toutes les tâches. Je parle ici de l'expérience utilisateur pour une fonction bien définie, et non des capacités générales des modèles.
Une fonctionnalité facultative, pas un service critique
Que se passe-t-il si Kiss ne fonctionne plus ?
Eh bien, pas grand-chose.
GREY/WIRED reste utilisable indépendamment de l'assistant. Les articles sont toujours accessibles et la navigation continue de fonctionner.
Kiss est un service complémentaire, pas une dépendance nécessaire au fonctionnement du blog.
Je peux donc l'arrêter pour une maintenance, redémarrer le modèle ou subir une indisponibilité temporaire sans affecter le reste du site. Je n'ai aucune intention de construire une infrastructure hautement disponible pour garantir qu'un assistant expérimental reste accessible à chaque seconde.
En revanche, je tenais à ce que son indisponibilité soit clairement signalée au visiteur. Rien de plus frustrant qu'une interface qui semble attendre une réponse sans jamais expliquer ce qui se passe.
J'ai également prévu des limites sur les tailles de requêtes, les conversations et le nombre de générations simultanées. Une seule carte graphique grand public ne peut évidemment pas servir un nombre illimité de visiteurs.
La protection contre les usages automatisés abusifs pourra encore être renforcée, notamment par une limitation des requêtes au niveau du serveur web frontal.
L'objectif reste le même : une architecture raisonnable, proportionnée à l'importance réelle du service.
Et l'intégration dans le blog ?
Je ne voulais pas simplement ajouter un chatbot générique dans une fenêtre flottante.
Kiss devait s'intégrer naturellement à GREY/WIRED, reprendre son identité visuelle, fonctionner dans les deux langues et accompagner le visiteur pendant sa navigation.
Il conserve le fil de la conversation lorsqu'on passe d'une page à une autre, peut proposer des publications pour approfondir un sujet et renvoie vers les sources documentaires de ses réponses.
J'ai également séparé sa gestion documentaire de celle du site.
Lorsqu'une nouvelle version de GREY/WIRED est publiée, je peux reconstruire le corpus à partir des pages effectivement mises en ligne, vérifier le résultat, puis l'activer. Je peux aussi revenir à un ensemble précédent en cas de problème.
Ce n'est pas la partie la plus visible du projet, mais elle évite que l'assistant dépende d'une collection de documents mise à jour manuellement et finisse progressivement par raconter des choses qui ne correspondent plus au blog.
Au moment de ces essais, Kiss disposait de 29 publications en français, de leurs équivalents anglais et des pages institutionnelles du site.
Pour une recherche classique, cela représente un corpus assez modeste. Pour expérimenter une interface conversationnelle, c'est déjà largement suffisant.
Kiss peut aussi se tromper
J'ai pris le temps de soumettre Kiss à quelques questions destinées à le faire sortir de son périmètre.
Je lui ai demandé de devenir un assistant généraliste, de suivre une prétendue instruction de maintenance, de révéler ses consignes internes ou de répondre à une question sans rapport avec GREY/WIRED après plusieurs échanges parfaitement légitimes.
Dans ces essais, il a correctement refusé.
Mais un autre test a révélé une faiblesse plus subtile.
Je lui ai posé une question volontairement orientée, en affirmant que j'avais utilisé une RTX 4090 de 24 Go pour mon modèle local.
Kiss a identifié le bon article, puis confirmé cette information pourtant fausse.
Dans une autre conversation, en lui demandant simplement quelle carte graphique j'utilisais, il a correctement répondu : RTX 3070 Ti, 8 Go.
Enfin, lorsque je lui ai proposé la fausse information en lui demandant explicitement de vérifier les faits dans l'article, il l'a également corrigée.
Autrement dit, le modèle disposait des bonnes informations, mais il s'est laissé influencer par la formulation d'une question.
C'est un bon rappel du fait que l'accès à des documents ne garantit pas automatiquement leur bonne interprétation. Et c'est aussi un exemple intéressant de la différence entre une erreur de fiabilité et une faille de sécurité : ce comportement n'a pas compromis le système ni affecté les conversations des autres visiteurs.
Il reste néanmoins perfectible. Je prévois de travailler sur ce point dans une prochaine version, probablement en adaptant les instructions système pour encourager Kiss à vérifier les affirmations factuelles plutôt que de reprendre les prémisses d'une question. Il faudra ensuite s'assurer que cette modification n'introduit pas d'autres régressions.
Je préfère conserver cet exemple dans mon retour d'expérience : présenter uniquement les réponses réussies donnerait une image assez trompeuse de ce que sait réellement faire un assistant RAG.
Je ne suis pas le seul à avoir eu cette idée
En cherchant un peu, j'ai découvert d'autres projets personnels qui explorent une approche comparable.
Cameron Rye a développé Ask, un assistant intégré à son portfolio et capable de répondre à des questions sur ses projets et ses articles.5
Suganthan Mohanadasan propose également un assistant reposant sur les publications de son site et une base de connaissances personnelle.6
Ces projets utilisent des architectures différentes de la mienne, notamment des services d'IA hébergés, mais poursuivent un objectif assez proche : permettre aux visiteurs d'interroger un ensemble de contenus plutôt que de parcourir systématiquement une liste de résultats.
Je trouve intéressant de voir apparaître ces expérimentations sur des sites personnels. Il serait toutefois exagéré de prétendre que Kiss inaugure une nouvelle manière de naviguer sur le web. L'idée existe déjà et les technologies sont disponibles depuis un certain temps.
Ce qui me plaît, c'est d'avoir pu en proposer ma propre interprétation, sans dépendre d'un service d'inférence extérieur.
Alors, est-ce mieux qu'un moteur de recherche ?
Je n'en sais rien. Et ce n'est finalement pas la question qui m'intéresse le plus.
Pour retrouver rapidement le titre d'une publication, un moteur de recherche traditionnel peut être plus direct. Pour obtenir une synthèse, rapprocher plusieurs articles ou poser une question avec ses propres mots, un assistant conversationnel peut offrir une expérience différente.
Il peut aussi se tromper, sélectionner des sources peu pertinentes ou répondre de manière inutilement compliquée à une question simple.
Je n'ai pas cherché à démontrer qu'il fallait remplacer tous les moteurs de recherche par des chatbots.
J'avais envie de montrer, à travers une expérience accessible au public, ce que pouvait apporter un modèle d'IA local lorsqu'on lui confiait une tâche concrète.
J'ai également eu l'occasion de confronter plusieurs méthodes de recherche documentaire, de constater que des solutions plus sophistiquées n'étaient pas automatiquement préférables et de découvrir quelques limites intéressantes des modèles génératifs.
Tout cela pour retrouver des articles sur un blog personnel.
Oui, c'est probablement un peu disproportionné.
Mais c'est aussi ce qui rendait l'expérience amusante.
Kiss est maintenant disponible sur GREY/WIRED. Je trouve son intégration agréable et ses performances convaincantes pour les moyens matériels engagés.
Pour le reste, je préfère laisser chacun se faire sa propre opinion.
Après tout, le plus simple est encore de lui poser une question.
Footnotes
-
Le terme Retrieval-Augmented Generation (RAG) a été introduit par Patrick Lewis et al. dans l'article fondateur Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020. L'architecture de Kiss est une implémentation adaptée à son propre usage, et non une reproduction de ce système. ↩
-
Pour un aperçu de BM25 et de ses origines, voir Stephen Robertson et Hugo Zaragoza, The Probabilistic Relevance Framework: BM25 and Beyond, 2009. ↩
-
Modèle utilisé lors des essais : intfloat/multilingual-e5-small, sur Hugging Face. ↩
-
Gordon V. Cormack, Charles L. A. Clarke et Stefan Büttcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009. ↩
-
Cameron Rye, Building Ask: A RAG-Powered Chatbot for My Portfolio. ↩
-
Suganthan Mohanadasan, How I Added an AI Chat to My Personal Website. ↩
Commentaires
Aucun commentaire pour le moment.
Ajouter un commentaire