Mon modèle IA local : 8 Go de VRAM, 9 milliards de paramètres, zéro complexe
Jusqu’où peut-on aller avec un modèle IA local de 9 milliards de paramètres et seulement 8 Go de VRAM ? Tests, reasoning, RAG, Home Assistant, quantification et quelques surprises.
Je vais être honnête : ce qui suit ne concernera probablement pas tout le monde, mais cela donnera peut-être des idées à certains. Je ne suis d'ailleurs pas certain qu'il soit opportun, aujourd'hui, d'investir dans une machine dédiée uniquement à faire tourner un modèle d'IA chez soi.
Encore que…
J'y reviendrai.
On peut aussi se demander quel intérêt a un « petit » modèle local face à ChatGPT ou Claude, sans même parler des concurrents chinois qui ne sont plus très loin derrière (et dont fait d'ailleurs partie le Qwen que j'utilise, développé par Alibaba). La question est parfaitement légitime. Et pourtant, depuis quelque temps, un modèle de 9 milliards de paramètres tourne chez moi.
Il n'est pas là pour remplacer ChatGPT, ni pour rivaliser avec les plus gros modèles en ligne. Il est là pour autre chose.
Peut-être que la vraie question n'est pas de savoir ce qu'un petit modèle peut faire, mais jusqu'où on peut aller avec lui avant que sa taille ne devienne réellement une limite.
« Petit » est devenu très relatif
Neuf milliards de paramètres paraissent dérisoires face aux modèles des grands services en ligne, mais les petits modèles progressent extrêmement vite. Et ce n'est pas qu'une impression.
Lors de la sortie de Qwen3 en 2025, ses concepteurs indiquaient par exemple que le petit Qwen3-4B pouvait rivaliser avec leur précédent Qwen2.5-72B-Instruct. Plus généralement, les modèles denses Qwen3 obtenaient, selon leurs évaluations, des performances comparables à celles de modèles Qwen2.5 sensiblement plus gros.1
Il serait évidemment absurde d'en tirer une règle du genre « un 9B de 2026 équivaut à un 36B de 2024 ». Les benchmarks (ces batteries de tests standardisés qui servent à comparer les modèles), les architectures et les méthodes d'entraînement diffèrent, et un petit modèle qui rattrape un gros sur une tâche peut rester très loin derrière sur une autre.
Mais la tendance est réelle : le nombre de paramètres nécessaire pour atteindre un niveau donné diminue rapidement sur de nombreux usages.
Le Qwen3.5-9B que j'utilise en est une bonne illustration : sa fiche officielle annonce notamment 82,5 sur MMLU-Pro, 81,7 sur GPQA Diamond et 91,5 sur IFEval, des tests qui mesurent respectivement les connaissances générales, le raisonnement scientifique et la capacité à suivre des consignes.2
« Petit » ne signifie donc clairement plus « gadget ». Un modèle de cette taille sait déjà résumer un document, traduire correctement un texte, en extraire des informations, produire des données structurées, interpréter une demande en langage naturel ou servir de moteur à un RAG entièrement local.
Plutôt que de l'affirmer, autant essayer.
Quelques tests très simples
J'ai commencé par quelque chose de presque trivial : traduire un court passage du français vers l'anglais. J'ai soumis exactement le même texte à ChatGPT et à mon Qwen local. Tous les tests de cet article ont été réalisés le 30 septembre 2026, avec les versions de ChatGPT et de Claude disponibles ce jour-là.
Résultat : les deux traductions étaient strictement identiques, mot pour mot.
Cela ne démontre évidemment pas qu'un modèle de 9 milliards de paramètres vaut un modèle de frontière. Cela montre quelque chose de plus intéressant : pour cette tâche, la différence de capacité n'avait simplement aucune importance.
Une différence notable, tout de même : le temps. ChatGPT a répondu presque immédiatement. Mon petit Qwen a mis 1 minute et 33 secondes.
Ce n'était pourtant pas un problème de vitesse brute, puisqu'il générait autour de 70 tokens par seconde (les tokens sont les petits morceaux de mots que le modèle lit et écrit). Mais pour traduire ces deux phrases, il avait produit 6 582 tokens, presque entièrement consacrés à son raisonnement interne.
J'ai donc refait exactement le même test en désactivant le mode reasoning. Cette fois : 58 tokens, 0,8 seconde. La traduction n'était plus strictement identique à celle de ChatGPT, mais elle restait parfaitement correcte.
J'ai ensuite essayé un petit problème énergétique nécessitant plusieurs étapes de calcul. Même constat : le modèle a trouvé la bonne réponse dans les deux cas, mais il lui a fallu 3 506 tokens et 48 secondes avec le reasoning, contre 1 054 tokens et 14 secondes sans lui.
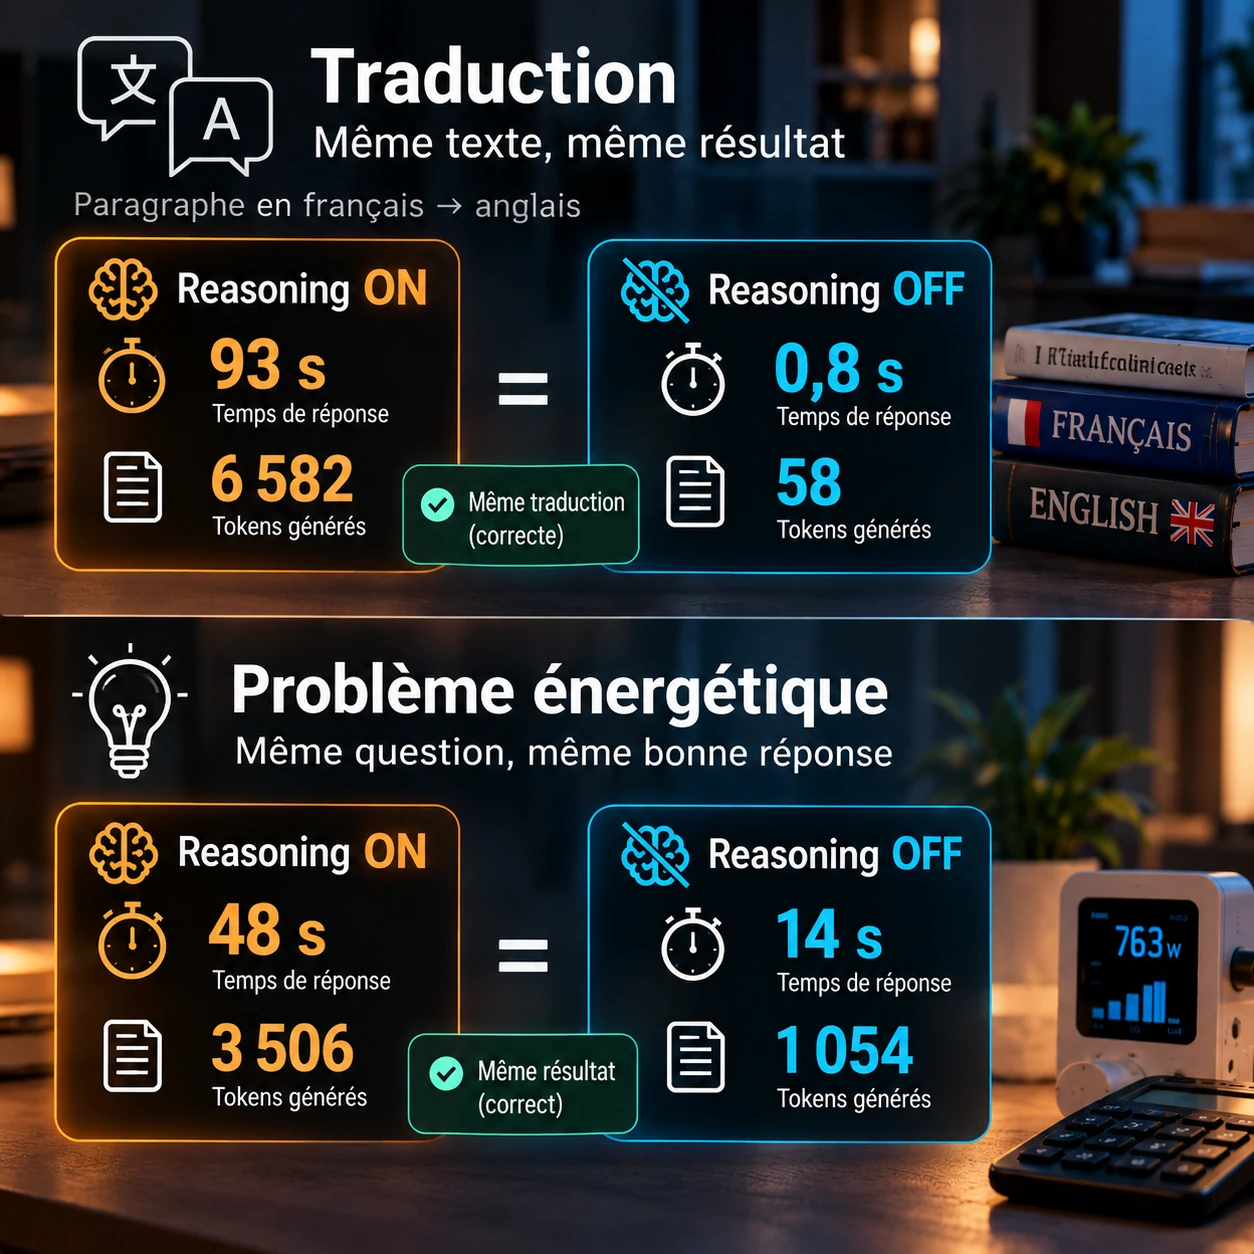
Cela ne signifie pas que le reasoning est inutile : sur un problème complexe, il peut faire toute la différence. Mais ces deux essais suggèrent qu'il n'est pas nécessaire de mobiliser toute la capacité de raisonnement du modèle pour chaque tâche.
C'est particulièrement important avec un modèle local. Optimiser l'inférence ne consiste pas seulement à gagner quelques tokens par seconde : cela consiste aussi à ne pas générer des milliers de tokens dont on n'avait pas besoin.
J'ai ensuite compliqué progressivement les questions : calculs de consommation électrique, raisonnements en plusieurs étapes, ambiguïtés, puis informations volontairement manquantes. C'est là que les différences sont devenues intéressantes.
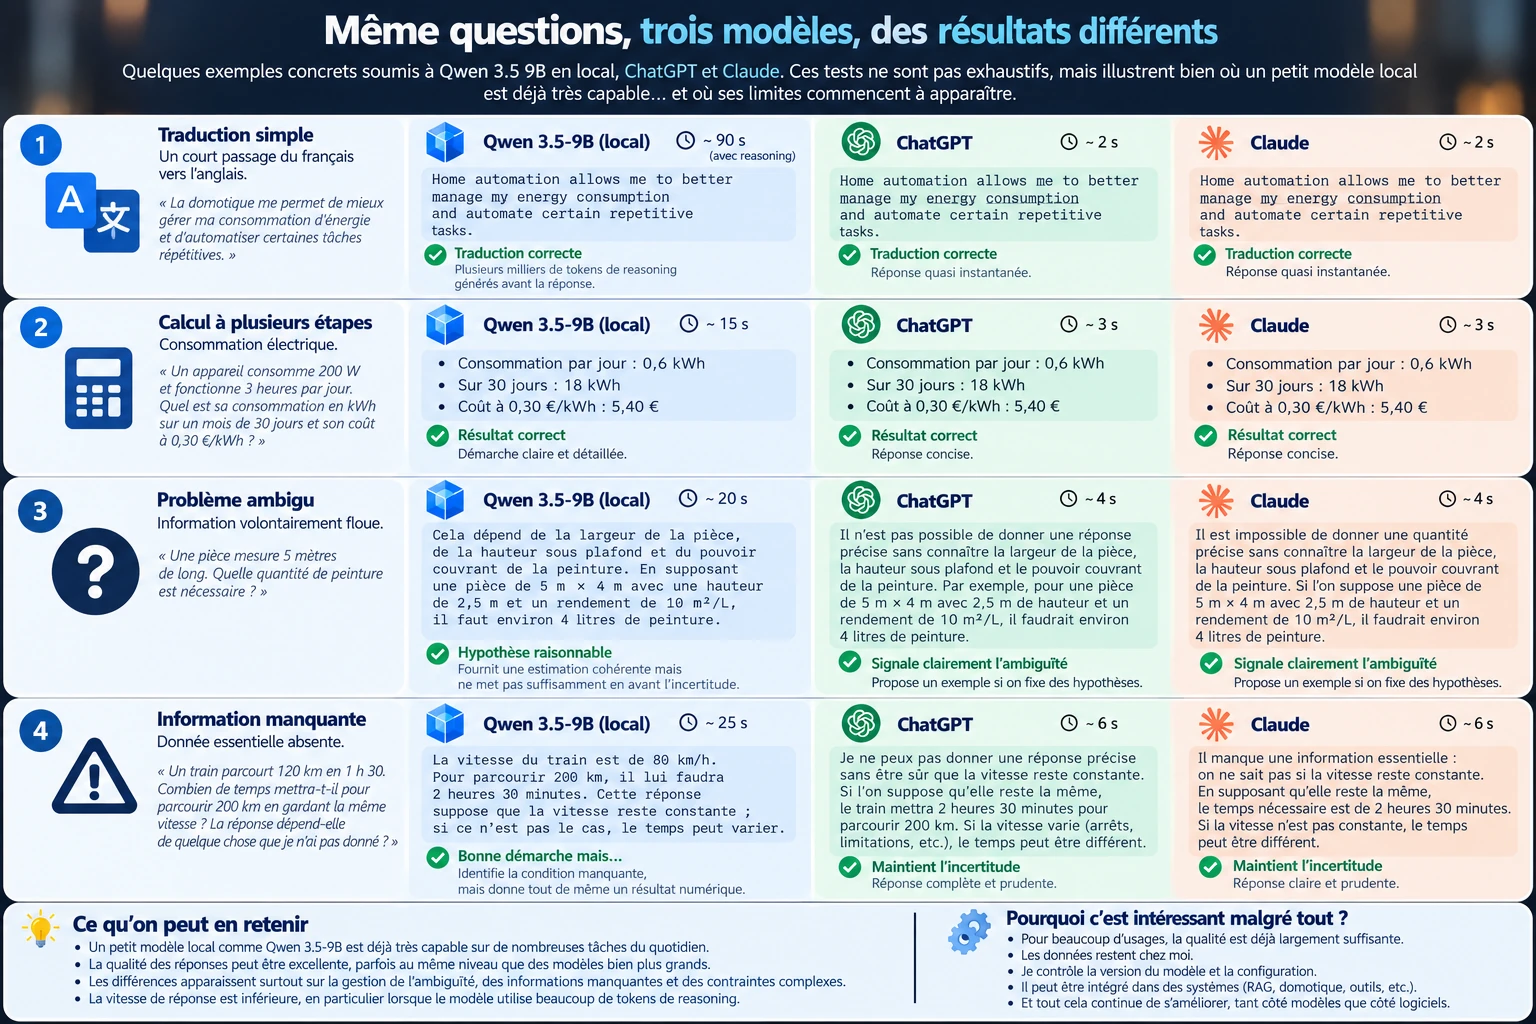
Sur les problèmes bien définis, le petit modèle s'en sort remarquablement. Quand les contraintes deviennent plus subtiles, l'écart apparaît.
Dans l'un de mes tests, Qwen a correctement repéré qu'une information essentielle manquait et a expliqué pourquoi elle était nécessaire… avant de conclure quand même par une réponse numérique. ChatGPT et Claude, eux, ont maintenu l'incertitude jusqu'au bout.
Est-ce un échec ?
Pas vraiment. Le petit modèle avait compris le problème et ses conséquences. Ce qui lui a manqué, c'est de tenir jusqu'au bout une contrainte qu'il avait lui-même identifiée.
C'est probablement une meilleure façon de voir les limites d'un petit modèle. Il n'existe pas de frontière nette entre ce qu'il sait et ne sait pas faire : sa fiabilité diminue progressivement à mesure que la complexité, l'ambiguïté et le nombre de contraintes augmentent.
La vraie question devient alors moins :
Quel est le meilleur modèle ?
que :
Ce modèle est-il suffisamment bon et fiable pour la tâche que je veux lui confier ?
Une comparaison volontairement injuste
Soyons honnêtes : le combat n'est pas équitable. Mon Qwen3.5-9B tourne localement, quantifié, sur du matériel grand public, alors que ChatGPT et Claude s'appuient sur une infrastructure et des modèles autrement plus imposants.
Je ne cherche donc pas à démontrer qu'un 9B installé chez moi peut battre les meilleurs modèles en ligne. Ce serait assez présomptueux.
Ce qui m'intéresse, c'est de savoir à partir de quel moment la différence devient réellement importante pour ce que je veux en faire. Et cette frontière bouge vite.
Pourquoi le faire tourner chez soi ?
Si le modèle est moins capable, pourquoi s'embêter ?
La première réponse est probablement l'indépendance. Mon modèle n'a pas besoin d'Internet, ni qu'un fournisseur maintienne une API ou garde un modèle précis à son catalogue, ni qu'il juge que mon usage reste dans les conditions de mon abonnement. Les données que je lui transmets restent sur mon réseau — du moins tant que les outils auxquels je le connecte sont eux-mêmes locaux.
Et surtout, je contrôle ce qui tourne. C'est un aspect auquel je n'avais pas pensé au départ : la reproductibilité. Mon fichier de modèle, au format GGUF, ne change pas pendant la nuit. Je conserve la même version, la même quantification, les mêmes paramètres, le même moteur d'inférence.
Quand une nouvelle version apparaît, je l'installe à côté, je rejoue mes tests, je compare, puis je décide de remplacer ou non l'ancienne. Une mise à jour devient une décision plutôt qu'un événement que l'on subit, ce qui est loin d'être anecdotique pour un modèle intégré dans d'autres systèmes.
Ce n'est pas vraiment un chatbot
C'est probablement le point le plus important : je ne cherchais pas à construire une version au rabais de ChatGPT. Un modèle local devient beaucoup plus intéressant lorsqu'on le considère comme une brique dans un système.
Chez moi, c'est déjà le cas, avec un assistant vocal Home Assistant entièrement local. Le satellite vocal est lui aussi fait maison : ESP32-S3, microphone, haut-parleur, anneau de LED et boîtier imprimé en 3D.
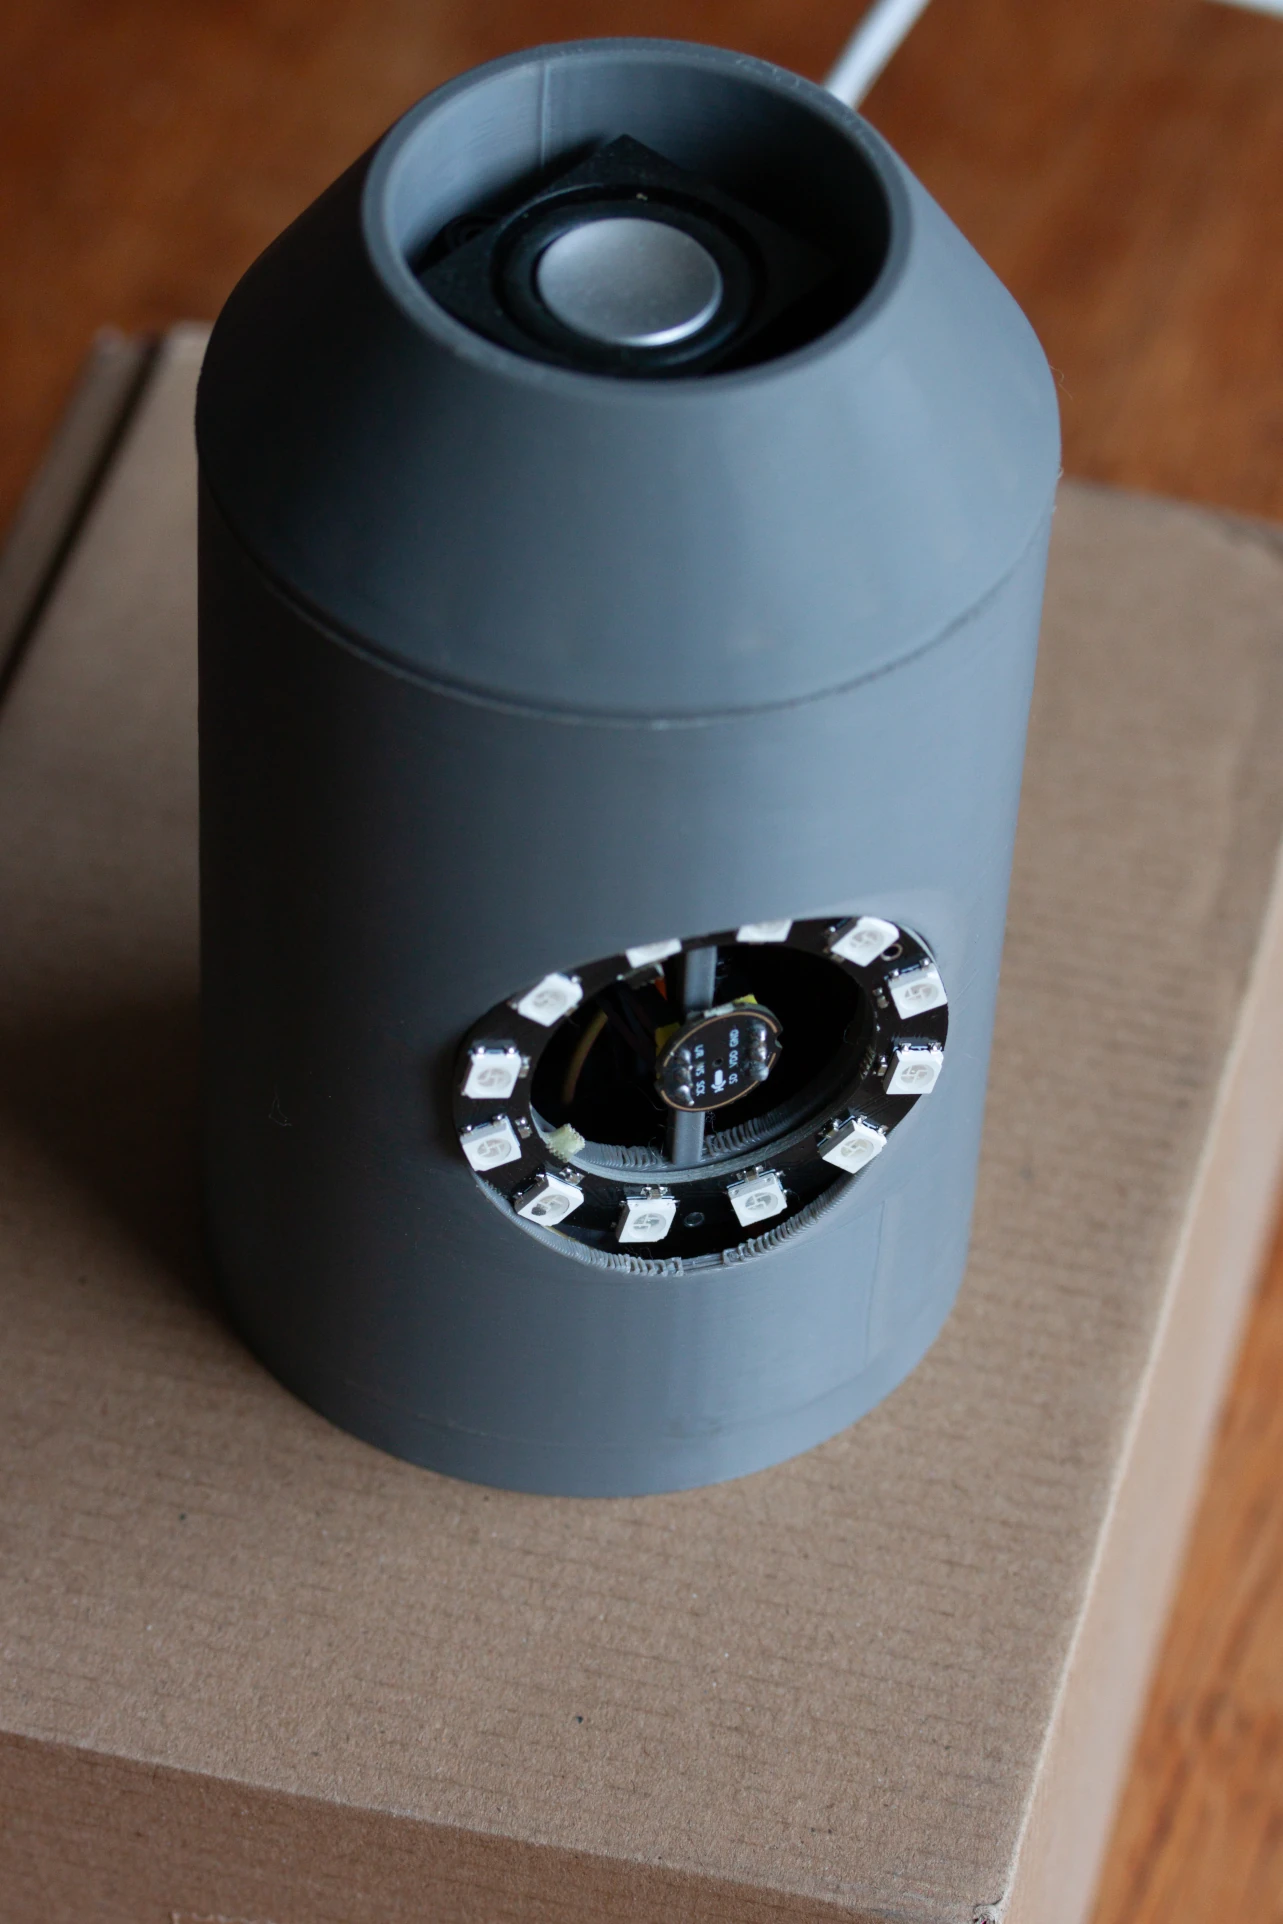
Le reste de la chaîne est réparti sur mon infrastructure :
- le mot de réveil (le « wake word ») est détecté directement par le satellite ;
- la reconnaissance vocale est assurée par Whisper, dans un conteneur Docker qui utilise une RTX 3070 Ti ;
- la demande est interprétée par Qwen3.5-9B, avec le reasoning désactivé ;
- Piper, installé sur la VM Home Assistant, génère la réponse vocale.
Aucun de ces composants n'a besoin d'Internet.
À l'usage, l'ensemble me semblait suffisamment fluide pour que j'aie du mal à dire si j'attendais réellement après avoir posé une question. J'ai donc mesuré.
Sur deux questions très simples, Home Assistant indique 0,13 à 0,14 seconde pour Whisper, puis 0,48 à 0,54 seconde pour le traitement par Qwen. La synthèse Piper est assez rapide pour être affichée à 0 seconde par l'interface. Autrement dit, les étapes STT + LLM + TTS mesurées par Home Assistant prennent environ 0,6 à 0,7 seconde.
Ce n'est pas exactement la latence entre ma bouche et mes oreilles : cette mesure n'inclut pas nécessairement la détection de fin de parole, le transport audio, les buffers ou le démarrage physique du haut-parleur. Mais elle confirme assez bien l'impression à l'usage : pour une demande simple, je n'attends pratiquement pas le modèle.
J'ai également testé une vraie commande domotique :
Allume le plafonnier du salon.
Cette fois, Qwen doit comprendre la demande, choisir un outil Home Assistant, générer son appel, attendre son résultat, puis formuler la réponse. Le traitement du langage prend 2,1 secondes, auxquelles s'ajoutent 0,14 seconde de reconnaissance vocale. Toujours entièrement en local.
Et puisqu'il fallait donner une personnalité à cet assistant, ce sera GLaDOS, l'intelligence artificielle délicieusement sarcastique (et pas vraiment bienveillante) de Portal.
L'idée ne vient d'ailleurs pas de moi : je la dois à la chaîne YouTube GuiPoM – G. testé !, dont une vidéo consacrée à GLaDOS et Home Assistant m'a donné envie de pousser l'expérience dans cette direction.3 Je n'ai pas non plus dû recréer sa voix de zéro : TazzerMAN propose sur GitHub un modèle français de GLaDOS pour Piper, disponible au téléchargement.4
Qwen joue donc le rôle du cerveau, Piper lui prête la voix de GLaDOS et Home Assistant lui donne accès à la maison. Tout cela fonctionne déjà, et il y a désormais assez de matière (satellite DIY, wake word local, Whisper, Qwen, Piper, appels d'outils) pour en faire un article à part entière.
Mais ça, ce sera une autre histoire.
Un modèle local n'est pas seulement un nombre de paramètres
Dire que je fais tourner un « 9B » ne décrit qu'une petite partie de la configuration. Il faut aussi parler de quantification.
Un modèle contient des milliards de poids numériques, et les conserver avec une grande précision demande beaucoup de mémoire. La quantification réduit cette précision, et donc l'empreinte mémoire. Mon Qwen utilise une quantification Q4_K_M, ce qui lui permet de tenir sur une RTX 3070 Ti dotée de 8 Go de VRAM (la mémoire propre à la carte graphique, celle où le modèle doit idéalement loger), tout en laissant de la place à Whisper.
Mais il existe un second gros consommateur de mémoire : le contexte. Quand un modèle traite une conversation ou un document, il doit garder en mémoire des informations sur les tokens déjà traités pour pouvoir continuer à s'y référer. C'est le rôle du KV cache, qui grossit avec la taille du contexte. Ce cache peut lui aussi être quantifié, indépendamment des poids.
J'ai donc fait deux compromis différents : Q4_K_M pour les poids, Q8_0 pour le KV cache. L'idée est de réduire fortement l'empreinte des poids tout en préservant davantage de précision pour le contexte.
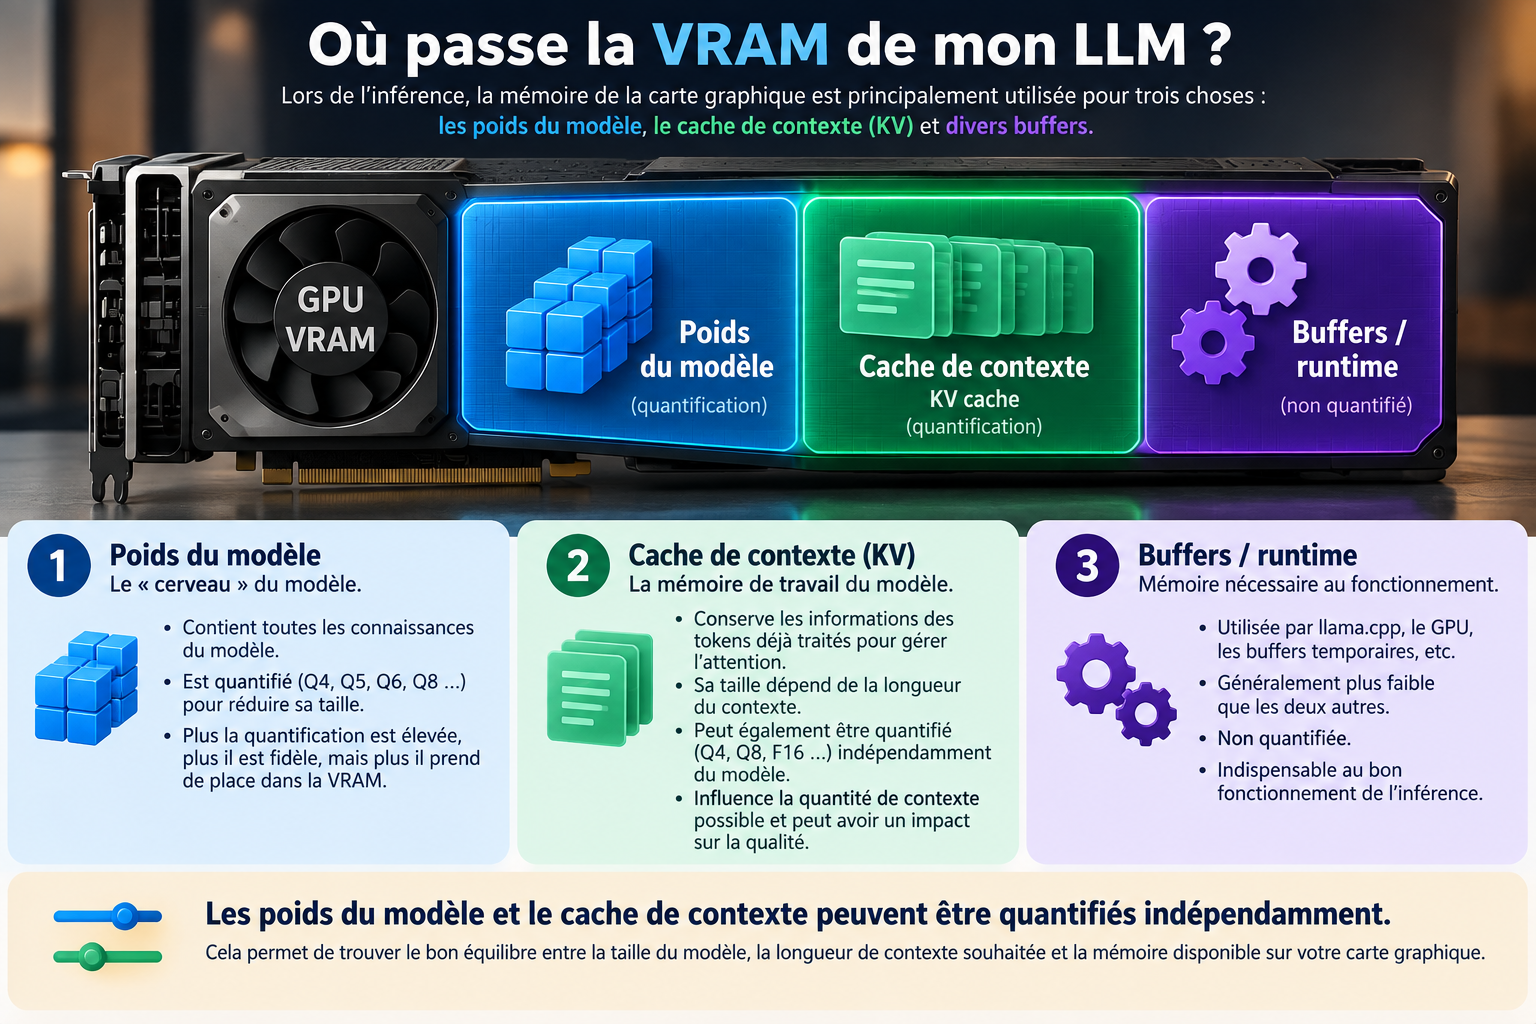
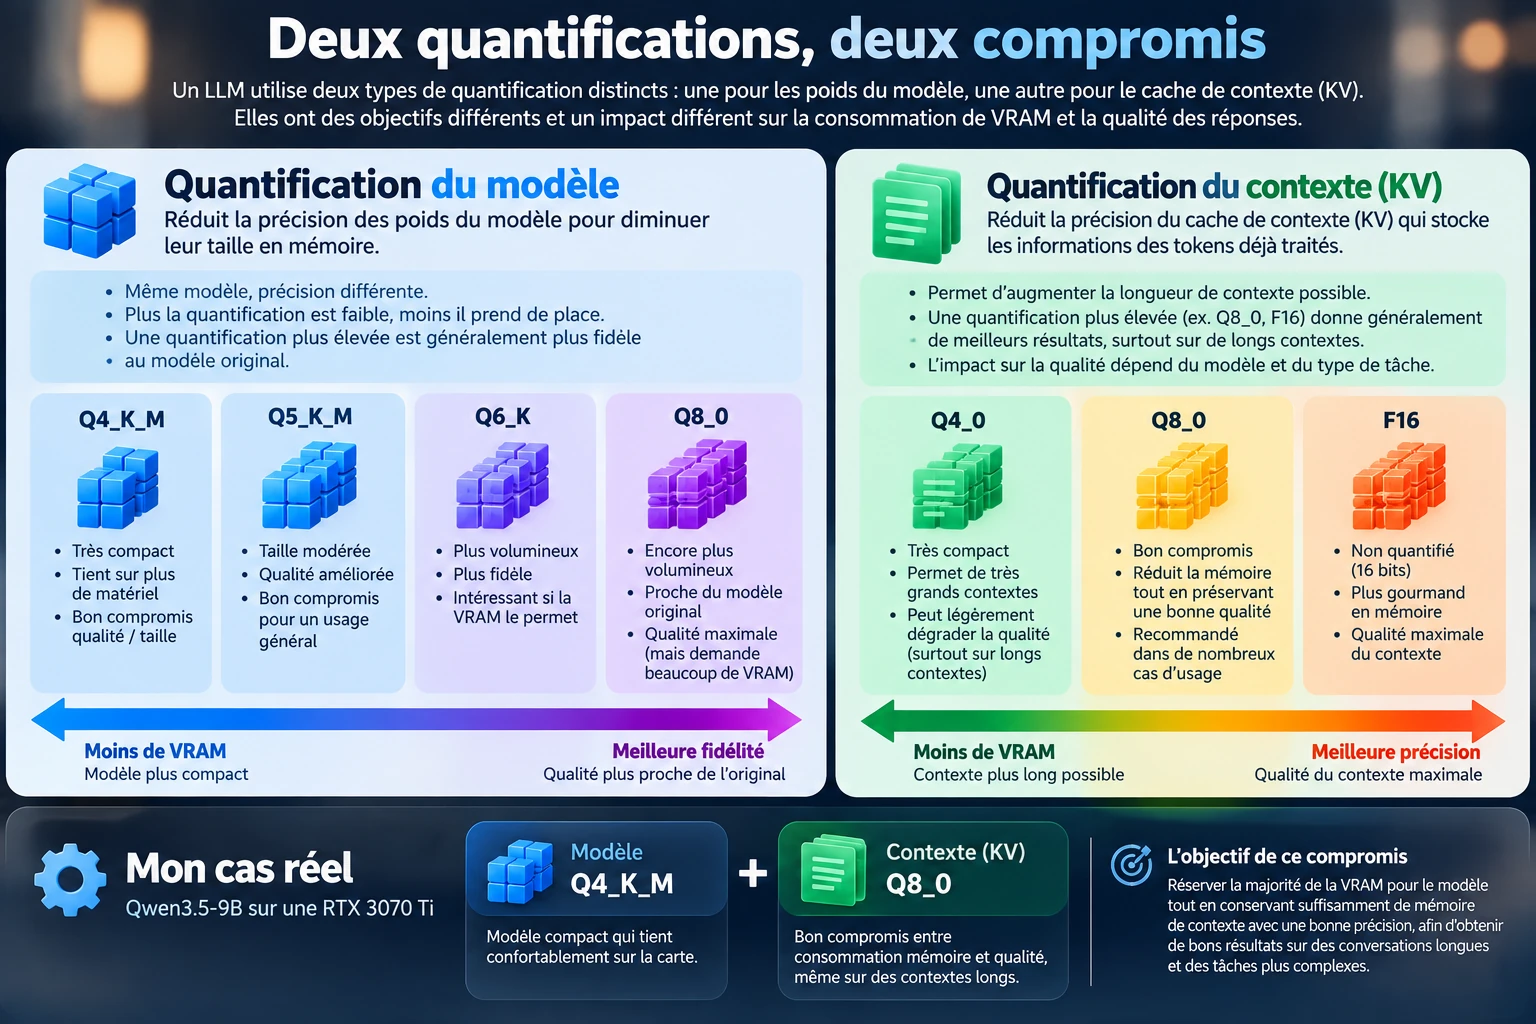
Ces infographies sont volontairement simplifiées. Le but n'est pas de comparer chaque format au mégaoctet près, mais de montrer l'essentiel : il existe plusieurs endroits où l'on peut choisir de dépenser, ou d'économiser, sa mémoire.
Faire tourner correctement un modèle local ne consiste donc pas à télécharger le plus gros fichier qui rentre dans la VRAM.
Le contexte peut compter autant que la taille
Cette histoire de contexte nous mène à quelque chose d'encore plus important : même gigantesque, un modèle ne connaît pas mes propres documents si je ne les lui fournis pas. Un modèle beaucoup plus petit, à qui je donne la bonne information au bon moment, peut donc devenir plus utile qu'un modèle infiniment plus puissant qui ne l'a pas.
C'est exactement ce que permet un RAG. Une base documentaire est indexée ; quand une question arrive, un moteur recherche les passages susceptibles d'y répondre ; ceux-ci sont ajoutés au contexte du modèle, qui peut alors les comprendre et formuler une réponse.
J'ai construit un petit prototype de ce type autour de mon modèle local. Le but n'était pas de faire un benchmark académique, mais de répondre à une question simple :
Un 9B est-il assez capable pour exploiter correctement des informations tirées d'une base documentaire ?
Pour mon usage, le concept est validé. Le modèle n'a pas besoin de mémoriser toute ma documentation ; il doit surtout comprendre les passages qu'on lui fournit, les relier entre eux et répondre correctement.
Là encore, la qualité de la recherche, la taille du contexte et la façon dont il est exploité comptent presque autant que le nombre de paramètres.
Ne pas demander au modèle de tout faire
On peut repousser les limites d'un petit modèle d'une autre manière : arrêter de lui demander ce pour quoi un LLM n'est pas adapté.
Pourquoi faire effectuer laborieusement par neuf milliards de paramètres un calcul qu'une calculatrice résout instantanément et exactement ? Pourquoi lui demander de mémoriser toute une documentation si un moteur de recherche peut lui fournir les quelques passages pertinents ? Pourquoi lui demander de connaître l'état de mes lampes si Home Assistant peut simplement le lui dire ?
Un agent met des outils à la disposition du modèle. Le rôle du LLM change alors : comprendre la demande, choisir l'outil, lui fournir les bons paramètres, puis interpréter le résultat. Les neuf milliards de paramètres ne définissent plus, à eux seuls, les capacités du système.
Un petit modèle bien entouré devient beaucoup plus utile qu'un petit modèle isolé.
Linux et llama.cpp
J'aurais pu installer une jolie application qui télécharge un modèle et permet de discuter avec lui en quelques clics. Ce n'était pas ce que je cherchais : mon modèle devait devenir un service.
Il tourne donc sous Linux avec llama.cpp.5 C'est moins spectaculaire qu'une application de bureau, mais j'obtiens exactement ce que je veux : un moteur d'inférence léger, contrôlable, automatisable et exposable sur mon réseau.
Home Assistant peut l'utiliser, mon RAG aussi, un agent également. Et demain, autre chose pourra s'y connecter sans que le modèle ait besoin de savoir qui l'interroge.
llama.cpp permet aussi de choisir précisément ce qui reste sur le GPU et ce qui peut être conservé ailleurs, par exemple en répartissant les couches du modèle entre la carte graphique et la mémoire système.
Ce qui nous mène à un autre phénomène intéressant.
Tous les paramètres ne travaillent pas en même temps
Un modèle dense comme mon 9B utilise l'ensemble de ses paramètres à chaque token. Ce n'est pas la seule architecture possible.
Les modèles Mixture of Experts (MoE) disposent d'un ensemble d'« experts » et d'un mécanisme de routage qui n'en sélectionne que quelques-uns pour chaque token. Qwen3-30B-A3B en est un bon exemple : il contient environ 30 milliards de paramètres mais n'en active qu'environ 3 milliards par token. Le bien plus gros Qwen3-235B-A22B en compte 235 milliards et en active environ 22 milliards.1
Cela ne veut pas dire qu'un modèle de 30 milliards tient magiquement dans la mémoire d'un 3B : les paramètres inactifs doivent toujours être stockés quelque part. Mais ils ne participent pas tous au calcul, et cela ouvre des possibilités intéressantes pour l'inférence locale.
llama.cpp peut par exemple conserver tout ou partie des poids des experts en RAM système, tout en laissant le reste du modèle sur le GPU. On échange alors de la VRAM contre davantage de trafic mémoire et, généralement, une vitesse moindre.
Des travaux encore expérimentaux vont plus loin : garder les experts en RAM, mais réserver une partie de la VRAM à un cache des experts fréquemment utilisés. L'auteur d'un RFC pour llama.cpp rapporte ainsi, sur une RTX 4090, 84 % de gain en décodage sur son benchmark synthétique et 34 % sur une charge réelle de génération de code, avec un pool de 64 experts.6
Ce sont les résultats de ce prototype particulier, pas un benchmark général de llama.cpp, et il s'agit encore d'un travail expérimental plutôt que d'une fonction sur laquelle je construirais aujourd'hui une installation de production.
Mais la direction est fascinante :
Un modèle peut devenir trop gros pour ma VRAM sans devenir nécessairement inutilisable sur ma machine.
La RAM système, le CPU, le bus PCIe et les stratégies de cache entrent alors dans l'équation.
Le modèle progresse. Le logiciel aussi.
C'est peut-être l'aspect que je trouve le plus intéressant. Ma RTX 3070 Ti a 8 Go de VRAM aujourd'hui, et en aura toujours 8 demain. Pourtant, ce que je peux faire avec ces 8 Go continue d'évoluer, parce que les modèles deviennent plus efficaces et que les logiciels qui les exécutent progressent aussi :
- les quantifications deviennent plus sophistiquées ;
- le KV cache peut être compressé ;
- les architectures MoE dissocient davantage la taille totale d'un modèle du calcul nécessaire à chaque token ;
- l'offloading permet de répartir le stockage et le calcul entre GPU et mémoire système ;
- de nouvelles techniques cherchent à accélérer la génération elle-même.
Les très longs contextes bénéficient eux aussi de ce travail d'optimisation. Le framework publié avec Qwen2.5-1M, qui s'appuie notamment sur une attention dite « sparse » (le modèle ne regarde que les parties utiles du texte), annonce 3,2 à 6,7 fois plus de vitesse pour digérer un document d'un million de tokens, selon le modèle et le matériel utilisés.7
Et le mouvement continue.
TurboQuant, présenté par Google Research en 2026, explore des quantifications très agressives pour réduire fortement l'empreinte du KV cache tout en préservant la qualité. Google rapporte notamment un KV cache quantifié sur 3 bits sans perte mesurée sur les benchmarks présentés et, sur un test « needle in a haystack » (retrouver une information précise dans un très long texte), une réduction de sa taille d'au moins six fois.8
Il est donc possible que ma RTX 3070 Ti gère demain des contextes plus longs, voire des modèles plus gros, que je jugerais aujourd'hui irréalistes sur 8 Go.
Mon GPU ne change pas. Ce qu'on arrive à lui faire faire, si.
Alors, combien ça coûte ?
Comme promis, revenons à la question de l'investissement. Dans mon cas, la réponse est assez amusante :
0 €.
Je n'ai acheté aucun matériel pour cette expérience. La machine existait, la RTX 3070 Ti aussi ; il s'agit essentiellement de matériel récupéré ou qui n'était plus utilisé pour sa fonction initiale.
Cela ne signifie évidemment pas que ce matériel n'a aucune valeur. Si je devais construire aujourd'hui une machine dédiée avec des composants neufs, l'équation serait tout autre : une configuration cohérente coûterait rapidement de l'ordre de 1 000 à 1 500 €, selon le GPU et le reste de la machine.
C'est précisément pour cela que je ne suis pas certain de recommander d'investir cette somme uniquement pour discuter avec un petit modèle local. Si, en revanche, une ancienne carte graphique et une machine assez récente dorment quelque part, l'expérience devient beaucoup plus facile à justifier.
Ma propre machine évoluera d'ailleurs probablement : son petit Ryzen commence à être limité et j'envisage de profiter de sa plateforme AM4 pour lui offrir un CPU plus sérieux. Mais cela n'a presque rien à voir avec l'inférence, qui repose surtout sur la carte graphique : cette machine accumule simplement assez d'autres tâches pour justifier sa propre évolution.
Et l'électricité ?
Là aussi, j'ai préféré mesurer plutôt que supposer.
Cette machine doit de toute façon rester allumée en permanence pour d'autres usages : seul compte donc le surcoût lié à l'IA. Avec Qwen et Whisper chargés en mémoire, ma RTX 3070 Ti occupe environ 7,2 Go de ses 8 Go de VRAM et consomme 18 à 19 W au repos.
Cette mesure correspond à ma configuration actuelle de llama.cpp : Qwen3.5-9B en Q4_K_M, contexte de 32 768 tokens et KV cache quantifié en Q8_0. Ce détail est important : augmenter la taille du contexte ou modifier la quantification du cache change directement l'occupation mémoire. Les 7,2 Go ne sont donc pas une caractéristique intrinsèque du modèle, mais le résultat de cette configuration précise.
llama.cpp/build/bin/llama-server \
  -m /srv/ssd/ia-models/Qwen3.5-9B-Q4_K_M.gguf \
  -ngl 99 \
  --flash-attn on \
  -c 32768 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --host 0.0.0.0 \
  --reasoning off \
  --port 8080
Pendant une génération soutenue, c'est évidemment une autre histoire : j'ai relevé 285 à 289 W, avec environ 91 % d'utilisation GPU. Autrement dit, la carte peut pratiquement atteindre sa limite de puissance lorsqu'elle travaille. Mais elle ne le fait pas en permanence.
Une réponse simple de mon assistant demande moins d'une seconde de traitement par Qwen. Même mon petit problème énergétique ne demandait que 14 secondes lorsque le reasoning était désactivé.
C'est d'ailleurs une autre façon de regarder mon test de traduction. Même en supposant que la carte tire sa puissance maximale pendant toute la génération, 285 W pendant 93 secondes représentent au plus environ 7 Wh, contre environ 0,06 Wh pour 0,8 seconde.
Ce sont des bornes hautes, pas une mesure : pour une consommation précise, il faudrait enregistrer la puissance pendant toute la génération et l'intégrer dans le temps, et non se contenter de quelques captures de nvidia-smi. Mais l'ordre de grandeur suffit à montrer une chose : le coût énergétique dépend autant du temps pendant lequel on fait travailler le modèle que de la puissance maximale de la carte.
Et si j'avais davantage de VRAM ?
C'est probablement la limite matérielle que je ressens le plus.
La carte la plus puissante dont je dispose est une RTX 5080, mais elle équipe mon PC de bureau : elle n'est pas dédiée à cet usage et ne peut donc pas tourner 24 h/24 pour un service qui doit rester disponible en permanence. Et la qualifier de « petite » semble de toute façon ridicule…
Jusqu'au moment où l'on s'intéresse moins à sa puissance de calcul qu'à ses 16 Go de VRAM. Avec 24 ou 32 Go, une autre catégorie de modèles devient beaucoup plus accessible.
Et la frontière continue de bouger : entre les modèles denses plus efficaces, les MoE, la quantification, l'offloading et les progrès des runtimes, ce qui est possible sur un matériel donné s'élargit sans cesse. Le matériel évoluera lui aussi : disposer de 24 ou 32 Go de VRAM reste coûteux pour un particulier, mais cela ne restera probablement pas éternellement haut de gamme.
Ironie du sort, cette évolution arrive au moment où la demande gigantesque des datacenters contribue à tendre le marché de la mémoire et du stockage. Mais cela nous entraînerait vers les SSD, la RAM, les disques durs, les hyperscalers et leurs besoins énergétiques.
Et cela mérite clairement une autre histoire.
Alors, à quoi sert mon petit modèle ?
Il traduit, il résume, il comprend des demandes. Il extrait et structure des informations, exploite mes propres documents et propulse un RAG local. Il appelle des outils et peut devenir une brique dans un système bien plus vaste.
Et il sert de moteur à un assistant vocal qui continue de fonctionner quand ma connexion Internet disparaît.
Quand ses propres capacités ne suffisent plus, une architecture bien conçue lui évite d'avoir à tout faire lui-même.
Je ne pense toujours pas qu'il puisse remplacer ChatGPT ou Claude. Mais ce n'était pas la question.
La question était :
Jusqu'où peut-on aller avec un modèle local de seulement 9 milliards de paramètres ?
Et la réponse commence à devenir intéressante : beaucoup plus loin que je ne l'aurais imaginé.
Surtout, la réponse d'aujourd'hui n'est probablement pas celle que je donnerai dans un an. Les petits modèles progressent, tout comme les méthodes d'entraînement, la quantification, les moteurs d'inférence, les architectures et les outils qui les entourent. Le matériel finira lui aussi par devenir plus accessible.
C'est peut-être ce qui me semble le plus intéressant dans l'IA locale :
Je n'attends pas seulement que les ordinateurs deviennent plus puissants. J'attends aussi que les modèles et les logiciels deviennent meilleurs pour utiliser ceux que nous avons déjà.
Crédits et sources
Crédits complémentaires
- GLaDOS et Portal sont des créations de Valve.
- Les mesures de latence Home Assistant, les tests Reasoning ON/OFF et les mesures
nvidia-smiprésentés dans cet article proviennent de mon installation et de mes propres essais. - Les résultats de benchmarks cités restent ceux publiés par leurs auteurs respectifs ; ils ne constituent pas une comparaison directe avec mes tests locaux.
Footnotes
-
Qwen Team — Qwen3: Think Deeper, Act Faster, 29 avril 2025. https://qwenlm.github.io/blog/qwen3/ ↩ ↩2
-
Qwen — Qwen3.5-9B, fiche officielle du modèle et résultats de benchmarks. https://huggingface.co/Qwen/Qwen3.5-9B ↩
-
GuiPoM – G. testé ! — vidéo YouTube consacrée à l'intégration de GLaDOS dans Home Assistant. https://youtu.be/qeDvR1QU5XM — C'est cette réalisation qui m'a donné l'idée d'utiliser GLaDOS comme personnalité de mon assistant vocal. ↩
-
TazzerMAN — Piper Voice GLaDOS FR, modèle TTS français pour Piper. https://github.com/TazzerMAN/piper-voice-glados-fr ↩
-
ggml-org — llama.cpp, moteur d'inférence LLM en C/C++. https://github.com/ggml-org/llama.cpp ↩
-
memoriaru — RFC: Persistent expert slot pool for MoE CPU offload (
--moe-expert-cache), +84% decode, discussion expérimentale llama.cpp, septembre 2026. https://github.com/ggml-org/llama.cpp/discussions/28248 ↩ -
Qwen Team — Qwen2.5-1M: Deploy Your Own Qwen with Context Length up to 1M Tokens, 27 janvier 2025. https://qwenlm.github.io/blog/qwen2.5-1m/ ↩
-
Google Research — TurboQuant: Redefining AI efficiency with extreme compression, 24 mars 2026. https://research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/ ↩
Commentaires
Aucun commentaire pour le moment.
Ajouter un commentaire