J'ai invité Internet sur mon blog. Les robots sont venus.
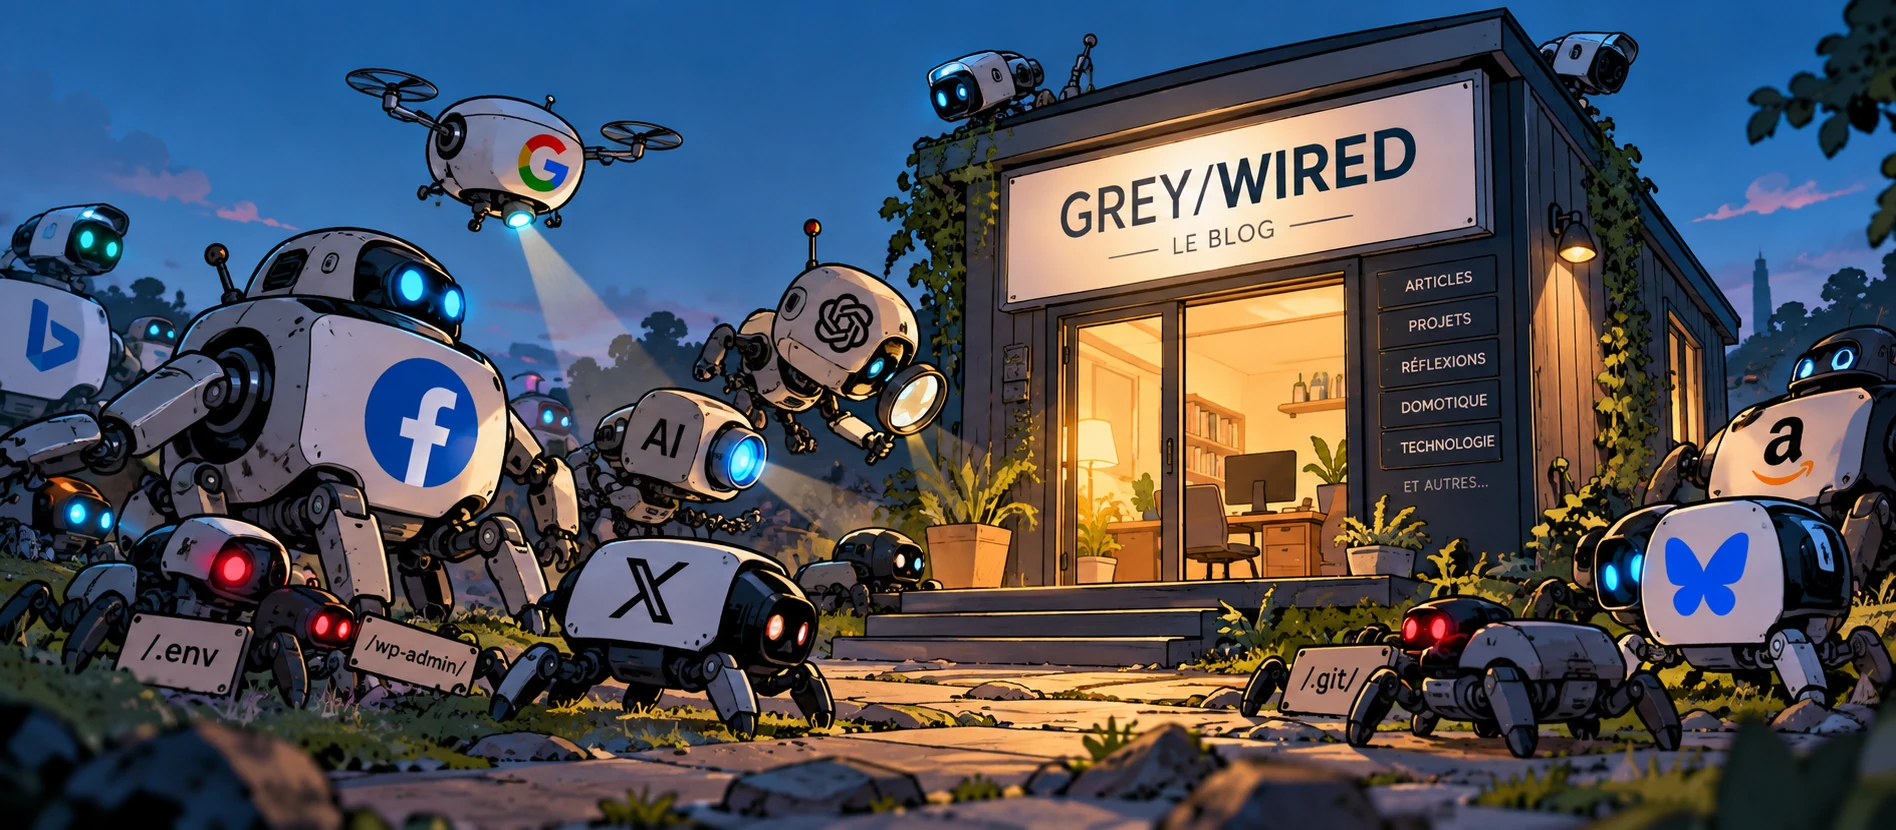
Premier bilan de mon expérience sur les réseaux sociaux : quelques chiffres, beaucoup de robots et toujours très peu de lecteurs.
Il y a quelques semaines, j'ai décidé de tenter une petite expérience : faire connaître GREY/WIRED via les réseaux sociaux.
J'ai créé des comptes sur Facebook, X et Bluesky, sans les associer à mon réseau personnel. L'idée était de publier régulièrement quelques contenus, sans publicité, sans chercher à accumuler des abonnés et sans stratégie de communication particulière. Juste voir si des publications pouvaient susciter un peu de curiosité et amener quelques visiteurs sur mon blog.
Entre le 18 septembre et le 12 octobre 2026, j'ai ainsi publié 60 messages sur les trois plateformes :
| Réseau | Publications |
|---|---|
| 25 | |
| X | 25 |
| Bluesky | 10 |
| Total | 60 |
Pas question non plus de transformer cela en deuxième métier. J'ai suffisamment d'occupations comme ça.
Après un peu plus de trois semaines et 60 publications, j'ai décidé de regarder ce que racontaient les logs de mon serveur Apache.
Et à première vue, Internet semblait avoir répondu à mon invitation.
Enfin… une certaine partie d'Internet.
30 627 requêtes. Champagne ?
Du 18 septembre au 12 octobre 2026, mon serveur a enregistré 30 627 requêtes HTTP.
Pour un petit site personnel qui vient de démarrer son expérience sur les réseaux sociaux, voilà qui pourrait sembler encourageant.
Sauf qu'une requête HTTP n'est pas une visite. Une page peut déclencher le chargement de dizaines de ressources, et un robot peut parcourir des centaines d'URL sans qu'un seul être humain ne pose les yeux sur le contenu.
J'ai donc exclu ma propre adresse IP et les accès locaux, pour conserver 29 241 requêtes externes.
Voici ce que donne un premier classement :
| Nature du trafic | Requêtes | Part |
|---|---|---|
| Robots et outils identifiés | 13 697 | 46,8 % |
| Requêtes vers des chemins de scan suspects | 7 674 | 26,2 % |
| Autres requêtes, non classées | 7 870 | 26,9 % |
| Total | 29 241 | 100 % |
Cette répartition repose sur les signatures des outils et les URL demandées. Les catégories sont exclusives : lorsqu'une requête vise un chemin suspect, je la classe comme scan, même si son User-Agent annonce également un robot.
Et surtout, les 26,9 % non classés ne sont pas des visiteurs humains. On y retrouve des images, des fichiers JavaScript, des feuilles de style et probablement encore pas mal de robots qui ont eu la délicatesse de ne pas se présenter comme tels.
Autrement dit, près des trois quarts du trafic externe peuvent déjà être associés à une activité automatisée ou suspecte, sans même examiner en détail le reste.
Facebook, les moteurs de recherche et quelques visiteurs indiscrets
Facebook mérite une mention particulière. Les agents déclarés de l'écosystème Meta représentent environ 6 300 requêtes, soit plus d'un cinquième du trafic externe total.
C'est considérable.
Derrière, je retrouve notamment Applebot, Googlebot, Bingbot, Ahrefs, Semrush, Amazonbot ou encore Twitterbot.
Il y a aussi des robots associés à l'intelligence artificielle, dont ClaudeBot, ainsi que d'autres crawlers spécialisés.
Tout ce petit monde parcourt le site, récupère des pages, des images ou des métadonnées, parfois à plusieurs reprises.
Cela prouve au moins une chose : GREY/WIRED n'est pas invisible pour les machines.
Mais plusieurs milliers de requêtes de Facebook ne représentent évidemment pas plusieurs milliers de personnes qui auraient découvert mes articles. Une plateforme peut récupérer automatiquement un aperçu de lien sans qu'aucun utilisateur ne clique dessus.
Quant aux robots d'IA, leur présence m'amuse un peu. J'utilise moi-même l'IA pour explorer certains sujets et préparer mes textes, et voilà que d'autres systèmes automatisés viennent récupérer ce contenu.
La boucle est intéressante, même si je ne prétendrai pas qu'un robot qui télécharge un article l'a réellement lu au sens humain du terme.
Les scanners, eux, ne manquent pas de curiosité
L'autre grande catégorie est moins intéressée par mes réflexions que par les éventuelles erreurs de configuration de mon serveur.
Sur la période étudiée, 10 891 requêtes externes ont obtenu une réponse HTTP 404.
Parmi les chemins recherchés, quelques classiques :
| Fichier ou chemin recherché | Requêtes observées |
|---|---|
/wordpress/ |
94 |
/.git/config |
91 |
/.env |
74 |
/.env.backup |
59 |
/index.php |
58 |
/.git/HEAD |
55 |
/.aws/credentials |
48 |
Et ce n'est qu'un échantillon. Les variantes de .env se multiplient, tout comme les tentatives d'accès à des fichiers PHP, à des répertoires WordPress ou à des configurations potentiellement sensibles.
C'est assez amusant lorsqu'on sait que GREY/WIRED est un site statique construit avec Astro.
Les scanners cherchent donc essentiellement des choses qui n'existent pas. Ce qui ne les empêche pas de revenir.
Bien entendu, ce trafic n'est pas une preuve que le site est vulnérable ou compromis. Il montre surtout à quel point une machine exposée sur Internet attire automatiquement des visiteurs dont les intentions n'ont rien à voir avec son contenu.
Et les êtres humains dans tout ça ?
C'est la partie qui m'intéressait vraiment.
En analysant les User-Agent, les enchaînements de pages, les ressources téléchargées et les intervalles entre les requêtes, j'ai tenté d'identifier ce qui ressemblait à de véritables sessions de navigation.
Le premier filtrage a fait ressortir 225 sessions présentant certains indices de navigation crédibles. En appliquant des critères plus restrictifs, 127 conservaient un score technique élevé.
Puis, en me concentrant sur les sessions comprenant la consultation d'au moins un article, projet ou short, avec des chargements de ressources et une durée minimale observable, j'ai obtenu 45 sessions candidates, correspondant à 38 adresses IP distinctes.
Attention : ce ne sont pas 45 lecteurs confirmés.
Certains robots utilisent de véritables navigateurs, chargent les images et exécutent les scripts. Deux adresses particulièrement actives appartiennent d'ailleurs à des infrastructures de datacenter : l'une chez OVH à Londres, l'autre chez Velia.net.
Inversement, une personne qui consulte un seul article peut parfaitement passer sous le radar de cette méthode.
Il reste néanmoins quelques parcours assez convaincants, avec plusieurs pages consultées sur des périodes de dix, vingt ou quarante minutes.
Et c'est ici que mon expérience personnelle devient utile : je peux recouper certaines de ces visites avec des échanges que j'ai eus ou avec des liens que j'ai moi-même communiqués à des connaissances.
Une partie des visites potentiellement humaines n'a donc rien de spontané.
Mon impression, après cette première analyse, est que le trafic spontané généré par les réseaux sociaux est proche du néant. Je ne peux pas démontrer qu'il est strictement nul, mais je n'ai pas non plus de raison solide d'annoncer des résultats plus encourageants.
Une conversation n'est pas une visite
Sur Bluesky, j'ai pourtant eu quelques interactions intéressantes, dont un échange avec une personne qui réagissait à l'un de mes sujets techniques.
Une véritable discussion, avec des remarques qui méritaient d'être prises en considération.
Mais rien dans les logs ne me permet d'attribuer une visite du blog à cette personne.
Et finalement, pourquoi serait-elle venue ?
Elle avait découvert une publication, nous avions échangé et la conversation pouvait très bien se suffire à elle-même.
C'est probablement l'un des enseignements les plus concrets de cette expérience : obtenir une interaction sur un réseau social ne signifie pas que quelqu'un souhaite ensuite consulter le contenu original.
On pourrait d'ailleurs avoir une discussion intéressante avec une personne sans jamais savoir si elle a visité le site.
Cela complique un peu la mesure, mais ce n'est pas bien grave. Je préfère une conversation authentique à un compteur de visites artificiellement gonflé.
Et si la réponse était beaucoup plus simple ?
En discutant de ces résultats, j'ai commencé à m'interroger sur l'évolution de notre rapport à la lecture, à la concentration et à la consommation d'informations.
C'est un sujet intéressant, mais avant de chercher une explication sociologique à l'absence de visiteurs, il faut envisager une hypothèse beaucoup plus banale.
J'ai publié 60 messages sur trois réseaux sociaux où personne, ou presque, ne me connaît.
Ce n'est pas rien en termes de publications, mais cela ne signifie absolument pas que 60 occasions réelles de découvrir mon site se sont présentées. Sans audience constituée, rien ne garantit qu'un message soit vu, encore moins qu'il suscite une visite.
Je n'ai pas constitué de communauté, je ne participe pas activement à des groupes spécialisés et je publie des liens vers un site personnel encore peu connu.
Il n'y a donc rien de particulièrement surprenant à ce que ces publications passent largement inaperçues.
Le problème pourrait simplement être celui de la visibilité.
Participer à des discussions sur des forums, des communautés de domotique, d'électronique ou d'autres espaces spécialisés permettrait peut-être de rencontrer davantage de personnes intéressées.
Mais cela demande du temps, et je n'ai pas envie de consacrer mes soirées à développer une présence sur les réseaux sociaux. Quant à automatiser des interactions pour simuler une participation communautaire, c'est exclu. Même si la technique le permet, cela ne présente aucun intérêt à mes yeux.
L'objectif de cette expérience n'a jamais été de transformer GREY/WIRED en une machine à produire de l'audience.
Et puis, je ne facilite probablement pas la lecture
Il y a tout de même une deuxième hypothèse, plus personnelle.
Je n'écris pas vraiment des tutoriels.
Lorsque je raconte comment j'ai automatisé mes stores, installé une sonnette connectée ou tenté de faire fonctionner un appareil récalcitrant, je pourrais probablement résumer les informations utiles en quelques paragraphes.
Mais ce n'est pas ce qui m'intéresse le plus.
J'ai envie de raconter les circonstances, les problèmes rencontrés, les pistes abandonnées et parfois les petites absurdités qui accompagnent une expérience technique.
Je ne prétends pas que la solution retenue est la meilleure. C'est celle à laquelle je suis arrivé, compte tenu de mes connaissances, de mes contraintes et des événements rencontrés.
Avec d'autres circonstances, j'aurais peut-être fait des choix complètement différents.
Et c'est exactement la même démarche lorsque j'aborde des sujets de réflexion sur l'IA, l'éducation canine ou d'autres domaines qui éveillent ma curiosité.
Je ne raconte pas comment il faut faire. Je raconte comment j'en suis arrivé là.
C'est une forme de témoignage, davantage qu'un mode d'emploi.
Et cela produit des articles parfois longs, qui demandent au lecteur un investissement en temps et en attention.
Or, aujourd'hui, l'information vient continuellement nous solliciter. Passer quelques secondes sur une publication est une chose. Décider de quitter un flux pour consacrer dix minutes à une expérience racontée sur un blog en est une autre.
Je le constate d'ailleurs chez moi aussi : il m'arrive d'enregistrer un article intéressant pour le lire plus tard, puis de ne jamais revenir dessus. Non parce que le sujet aurait perdu son intérêt, mais simplement parce qu'autre chose a pris sa place.
Est-ce une conséquence des contenus courts, de la surabondance d'informations ou simplement de nos emplois du temps ? Probablement une combinaison de facteurs, dans des proportions que je serais bien incapable de déterminer.
Et mes statistiques ne permettent évidemment pas de trancher cette question.
Mais je soupçonne que le format que j'ai choisi réduit naturellement le nombre de personnes disposées à me lire.
Je peux vivre avec cela.
La suite de l'expérience
Je vais continuer à publier sur Facebook, X et Bluesky, sans changer radicalement la démarche.
Pas question de multiplier artificiellement les publications, de raccourcir systématiquement les articles ou de transformer mes récits en contenus formatés pour les algorithmes.
Je vais surtout essayer de mieux mesurer ce qui se passe.
Les logs Apache restent une source précieuse : ils permettent de suivre les robots, les scanners, les pages consultées et certains parcours de navigation. J'aimerais affiner cette analyse pour mieux distinguer les visiteurs humains des systèmes automatisés.
L'utilisation de liens identifiés par des paramètres UTM pourrait également m'aider à reconnaître plus facilement les visites provenant des différentes plateformes, même lorsque le navigateur ne transmet pas de référent.
Je pourrai ainsi comparer les résultats dans quelques mois : évolution des requêtes, visiteurs plausibles, provenance et éventuelles découvertes via les moteurs de recherche.
Je conserverai aussi le nombre de publications effectuées sur chaque réseau. C'est indispensable pour comparer des résultats qui, autrement, ne voudraient pas dire grand-chose.
Ce premier bilan ne suffit pas à condamner les réseaux sociaux comme moyen de faire découvrir un blog. Il décrit seulement ce que j'observe après quelques semaines, avec trois comptes récents et une communication volontairement limitée.
Alors, verdict ?
60 publications en un peu plus de trois semaines. Plus de 30 000 requêtes HTTP. Et toujours aucune audience spontanée significative que je puisse identifier avec confiance.
Ces chiffres ne racontent pas toute l'histoire. Ils ne mesurent ni le nombre de personnes ayant réellement vu mes publications ni l'intérêt éventuel qu'elles ont suscité. Ils montrent simplement que, dans les conditions de cette expérience, l'activité de publication ne se traduit pas par des visites humaines clairement identifiables.
J'espérais que certaines de mes expériences ou réflexions puissent intéresser quelques personnes. Pour l'instant, je n'ai guère d'éléments permettant de dire que les réseaux sociaux y contribuent réellement.
Mais GREY/WIRED reste avant tout un projet personnel, un endroit où je prends plaisir à documenter mes expériences, organiser mes idées et parfois remettre en question mes propres conclusions.
Je continuerai donc à écrire, que les statistiques s'améliorent ou non.
En attendant, j'ai invité Internet sur mon blog. Et pour l'instant, ce sont surtout les robots qui ont répondu présents.
Commentaires
Aucun commentaire pour le moment.
Ajouter un commentaire